数据结构与算法 - 基础 参考: https://github.com/callmePicacho/Data-Structres/blob/master/README.md
[SCU练习平台题解]课堂练习 练习 NO1,最大子列和问题
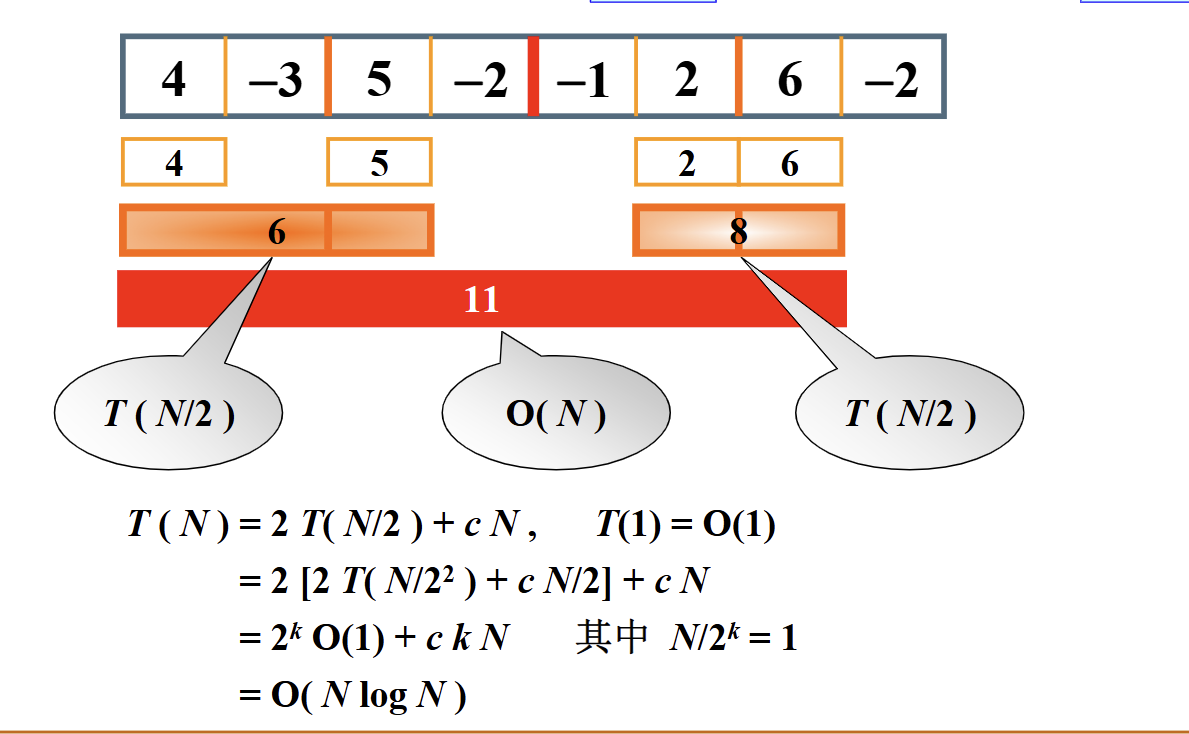
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 #include <bits/stdc++.h> using namespace std;int Max3 (int A,int B,int C) return A > B ? A > C ? A : C : B > C ? B : C;int DivideAndConquer (int List[],int left ,int right) int MaxLeftSum,MaxRightSum;int MaxLeftBorderSum,MaxRightBorderSum;int LeftBorderSum,RightBorderSum;int center,i;if (left == right)if (List[left] > 0 )return List[left];else {return 0 ;2 ;DivideAndConquer (List,left,center);DivideAndConquer (List,center+1 ,right);0 ,LeftBorderSum = 0 ;for (i = center;i >= left;i --){if (LeftBorderSum > MaxLeftBorderSum)0 ,RightBorderSum = 0 ;for ( i = center + 1 ;i <= right; ++ i)if (RightBorderSum > MaxRightBorderSum)return Max3 ( MaxLeftSum,MaxRightSum,MaxLeftBorderSum+MaxRightBorderSum);int MaxSubseqSum3 (int List[],int N) return DivideAndConquer (List,0 ,N-1 );
这题非常经典,分治法当然不是最好的。 “在线算法”实际上是贪心的方法,另一种办法是动态规划
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 #include <bits/stdc++.h> using namespace std;int dp[100005 ];int main () int t;cin >> t;for (int k = 1 ;k <= t;++ k)int n;cin >> n;for (int i = 1 ;i <= n;++ i)cin >> dp[i];int start = 1 ,end = 1 ,p = 1 ;int maxsum = dp[1 ];for (int i = 2 ;i <= n;++ i){if (dp[i-1 ] + dp[i] >= dp[i])-1 ] + dp[i];else p = i;if (dp[i] > maxsum)printf ("%d\n" ,maxsum);return 0 ;
但是时间复杂度是O(n*m)肯定会超时,考虑使用单调队列进行优化:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 #include <bits/stdc++.h> using namespace std;int > dq;int s[100005 ];int main () int n,m;scanf ("%d%d" ,&n,&m);for (int i = 1 ;i <= n;++ i)scanf ("%lld" ,&s[i]);for (int i = 1 ;i <= n;++ i)s[i] = s[i] + s[i-1 ];int ans = -1e8 ;push_back (0 );for (int i = 1 ;i <= n;++ i)while (!dq.empty ()&&dq.front () < i - m)dq.pop_front ();if (dq.empty ())ans = max (ans,s[i]);else ans = max (ans,s[i] - s[dq.front ()]);while (!dq.empty () && s[dq.back ()] >= s[i])dq.pop_back ();push_back (i);return 0 ;
由此可见,将数据结构与算法结合,威力无穷
NO2,多项式的加法和乘法
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 #include <bits/stdc++.h> using namespace std;#define maxn 10010 int a[maxn+1 ];int b[maxn+1 ];int c[maxn+1 ];int d[maxn+1 ];void getmul () int flag = 0 ;for (int i = 0 ;i <= maxn;++ i)if (a[i] != 0 )for (int j = 0 ;j <= maxn;++ j)if (b[j] != 0 )int mark = 0 ;for (int i = 0 ;i <= maxn;++ i)if (d[i] != 0 )break ;for (int i = maxn;i >= 0 ;i --)if (d[i] != 0 )1 ;" " << i << " \n" [i==mark]; if (flag == 0 )"0 0" << endl;void getsum () int flag = 0 ;for (int i = 0 ;i <= maxn;++ i)int mark = 0 ;for (int i = 0 ;i <= maxn;++ i)if (c[i] != 0 )break ;for (int i = maxn;i >= 0 ;i --)if (c[i] != 0 )1 ;" " << i << " \n" [i == mark]; if (flag == 0 )"0 0" << endl;int main () int num1,num2;while (num1--)int x,y;while (num2--)int x,y;getmul ();getsum ();return 0 ;
4 数组×40044 字节/数组=160176 字节 这大约是 156.5 KB。 这样虽然过了,但是没考虑过空间浪费。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 #include <bits/stdc++.h> using namespace std;#define maxn 10010 typedef struct LNode *List;struct data {int x;int y;struct LNode {struct data Data[maxn]; int Last;List init () malloc (sizeof (struct LNode));-1 ;return L;void insert (int x,int y,List L) return ;void getsum (List L1,List L2) int pointer1 = 0 ;int pointer2 = 0 ;while (pointer1 <= L1->Last && pointer2 <= L2->Last)if (L1->Data[pointer1].y > L2->Data[pointer2].y)printf ("%d %d " ,L1->Data[pointer1].x,L1->Data[pointer1].y);else if (L1->Data[pointer1].y < L2->Data[pointer2].y)printf ("%d %d " ,L2->Data[pointer2].x,L2->Data[pointer2].y);else {printf ("%d %d " ,L1->Data[pointer1].x + L2->Data[pointer2].x,L1->Data[pointer1].y);if (pointer1 <= L1->Last)printf ("%d %d " ,L1->Data[pointer1].x,L1->Data[pointer1].y);else if (pointer2 <= L2->Last)printf ("%d %d " ,L2->Data[pointer2].x,L2->Data[pointer2].y);int main () int num1,num2;init ();while (num1--)int x,y;insert (x,y,L1);init ();while (num2--)int x,y;insert (x,y,L2);printf ("\n" );getsum (L1,L2);return 0 ;
这段中尝试使用了动态数组实现顺序表的办法,完成了多项式加法
优势:相比上一份静态数组,处理数据时拿多少用多少。比如同样一组输入,空间占用从165kB降至不到100B。 缺点:虽然实现,但是代码中有几个问题: 1.在线算法,算一条输出一条,不灵活,这也解释了为什么乘法部分没有继续写。更好的做法是再开一个数组存答案。 2.输出部分未封装,题目部分有格式要求,较复杂的输出适合单独封装一个函数做输出。 3.空间连续,这是开数组和开链表的重要区别:数组空间必须物理上连续,而实际上计算机内存物理上并不连续,你以为的连续实际上是操作系统给出的抽象层,造成了空间连续的假象(逻辑上连续),这就会在要求比较苛刻的情况中浪费空间。 Tips:看懂一份代码不难,重要的是如何独立写出来。一个好办法是阅读注释,注释和编写过程中的调试遗迹是好东西,编写边调试即可化难为简。 可惜的是,大多数题解将调试遗迹删去。
最优解法:链表
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 #include <stdio.h> #include <stdlib.h> typedef struct Node *List;struct Node {int z; int x; List Read () {malloc (sizeof (struct Node));int n;int i=0 ;scanf ("%d" ,&n);for (i=0 ;i<n;i++){int x;int z;malloc (sizeof (struct Node));scanf ("%d %d" ,&x,&z);NULL ;return head->Next;List addition (List L1,List L2) {malloc (sizeof (struct Node));NULL ;while (tmpL1 && tmpL2){malloc (sizeof (struct Node));if (tmpL1->z == tmpL2->z){ else if (tmpL1->z < tmpL2->z){ else if (tmpL2->z < tmpL1->z){ if (tmpL1) else if (tmpL2) return head->Next; List multiplication (List L1,List L2) {malloc (sizeof (struct Node));NULL ;for (;tmpL1;tmpL1=tmpL1->Next)for (tmpL2 = L2;tmpL2;tmpL2=tmpL2->Next){malloc (sizeof (struct Node));NULL ;addition (t,mul); return head;void Print (List L) int flag = 1 ;for (;t;t = t->Next){if (!flag && t->x) printf (" " );if (t->x){ printf ("%d %d" ,t->x,t->z);0 ; if (flag)printf ("0 0" );printf ("\n" );int main () Read ();Read ();addition (L1,L2);multiplication (L1,L2);Print (mul);Print (add);return 0 ;
0908NO3,树的同构
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 #include <iostream> #include <malloc.h> #define null -1 using namespace std;struct TreeNode {char data; int left; int right; 10 ],T2[10 ];int create (struct TreeNode T[]) int n;int root = 0 ;char left,right;if (!n)return null;for (int i=0 ;i<n;i++){if (left=='-' )else {'0' ;if (right=='-' )else {'0' ;return root;bool judge (int R1,int R2) if (R1 == null && R2 == null) return true ;if (R1 == null && R2 != null || R1 != null && R2 == null) return false ;if (T1[R1].data != T2[R2].data) return false ;if ((T1[R1].left != null && T2[R2].left != null )&&(T1[T1[R1].left].data == T2[T2[R2].left].data)) return judge (T1[R1].left,T2[R2].left) && judge (T1[R1].right,T2[R2].right);else return judge (T1[R1].right,T2[R2].left) && judge (T1[R1].left,T2[R2].right);int main () int R1,R2;create (T1);create (T2);if (judge (R1,R2))"Yes" ;else "No" ;return 0 ;
之后的笔记就是关于大二下左老师算法设计课程。
Week2: 之前讲了完整的时间复杂度分析理论。这节课承接上文:
我们现代的普通计算机计算能力是每秒1亿次,10^9,当一个问题的计算规模超过10^13,一万亿次时,我们认为一般是不可接受的。
▶
为什么排序问题的最优时间复杂度是nlog(n)?
要理解为什么排序问题的最优时间复杂度是 ( \Omega(n \log n) ),我们需要考虑基于比较的排序算法的性质。基于比较的排序算法是那些仅通过比较元素来确定它们的顺序的算法。这些算法的最优时间复杂度由决策树模型来确定。
逐步解释: 决策树模型 :
在决策树模型中,每个内部节点代表两个元素之间的比较,每个叶节点代表可能的排序结果。 对于 ( n ) 个元素,有 ( n! )(n的阶乘)种可能的排列。因此,决策树必须至少有 ( n! ) 个叶节点。 树的高度 :
二叉树的高度是最大的路径长度从根到叶。在决策树中,高度代表最坏情况下的比较次数。 一个有 ( n! ) 个叶节点的二叉树的高度至少是 ( \log_2(n!) )。 斯特林近似 :
斯特林近似表明 ( n! \approx \sqrt{2 \pi n} \left( \frac{n}{e} \right)^n )。 使用这个近似,我们可以估计 ( \log_2(n!) \approx \log_2 \left( \sqrt{2 \pi n} \left( \frac{n}{e} \right)^n \right) )。 简化对数 :
( \log_2(n!) \approx \log_2 \left( \sqrt{2 \pi n} \right) + \log_2 \left( \left( \frac{n}{e} \right)^n \right) ) ( \log_2(n!) \approx \frac{1}{2} \log_2(2 \pi n) + n \log_2 \left( \frac{n}{e} \right) ) ( \log_2(n!) \approx \frac{1}{2} \log_2(2 \pi n) + n \log_2(n) - n \log_2(e) ) 主导项 :
当 ( n ) 变得很大时,项 ( n \log_2(n) ) 主导表达式。 因此,( \log_2(n!) \approx n \log_2(n) )。 结论 :
由于决策树的高度至少是 ( \log_2(n!) ),并且 ( \log_2(n!) \approx n \log_2(n) ),任何基于比较的排序算法在最坏情况下的比较次数至少是 ( n \log_2(n) )。 这意味着基于比较的排序算法的最优时间复杂度是 ( \Omega(n \log n) )。
之后还讲了递归算法的时间复杂度分析。
“这块东西你们其实以前也见过了,但是没有经过一个系统的学习,产生一个本质的了解。通过这两节课让大家对这个有一个本质的了解。”
递归与其说是一种算法,不如说是一种思维方式。(与数学归纳法类似的想法)
Week3: Week4: Week5: Week6: Week7: Week8: Week9: Week10: 矩阵的乘法次数
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 #include <bits/stdc++.h> using namespace std;int n;int q[110 ];int dp[110 ][110 ];int solve (int i, int j) if (i == j) {0 ;return 0 ;if (dp[i][j] != -1 ) return dp[i][j];int m = INT_MAX;for (int k = i; k < j; k++) {int cost = solve (i, k) + solve (k+1 , j) + q[i-1 ] * q[k] * q[j];if (cost < m) m = cost;for (int s = 1 ;s <= 10 ;s ++ ){for (int t = 1 ;t <= 10 ;t ++){" \n" [t==10 ];return m;int main () scanf ("%d" , &n);for (int i = 0 ; i <= n; i++) {memset (dp, -1 , sizeof dp);printf ("%d" , solve (1 , n));return 0 ;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 #include <iostream> using namespace std;const int N = 100 ;int A[N];int m[N][N];int s[N][N];void MatrixChain (int n) int r, i, j, k;for (i = 0 ; i <= n; i++)0 ;for (r = 2 ; r <= n; r++)for (i = 1 ; i <= n - r + 1 ; i++)1 ;1 ][j] + A[i - 1 ] * A[i] * A[j];for (k = i + 1 ; k < j; k++)int t = m[i][k] + m[k + 1 ][j] + A[i - 1 ] * A[k] * A[j];if (t < m[i][j])void print (int i, int j) if (i == j)"A[" << i << "]" ;return ;"(" ;print (i, s[i][j]);print (s[i][j] + 1 , j);")" ;int main () int n;int i, j;for (i = 0 ; i <= n; i++)MatrixChain (n);"最佳添加括号的方式为:" ;print (1 , n);"\n最小计算量的值为:" << m[1 ][n] << endl;return 0 ;
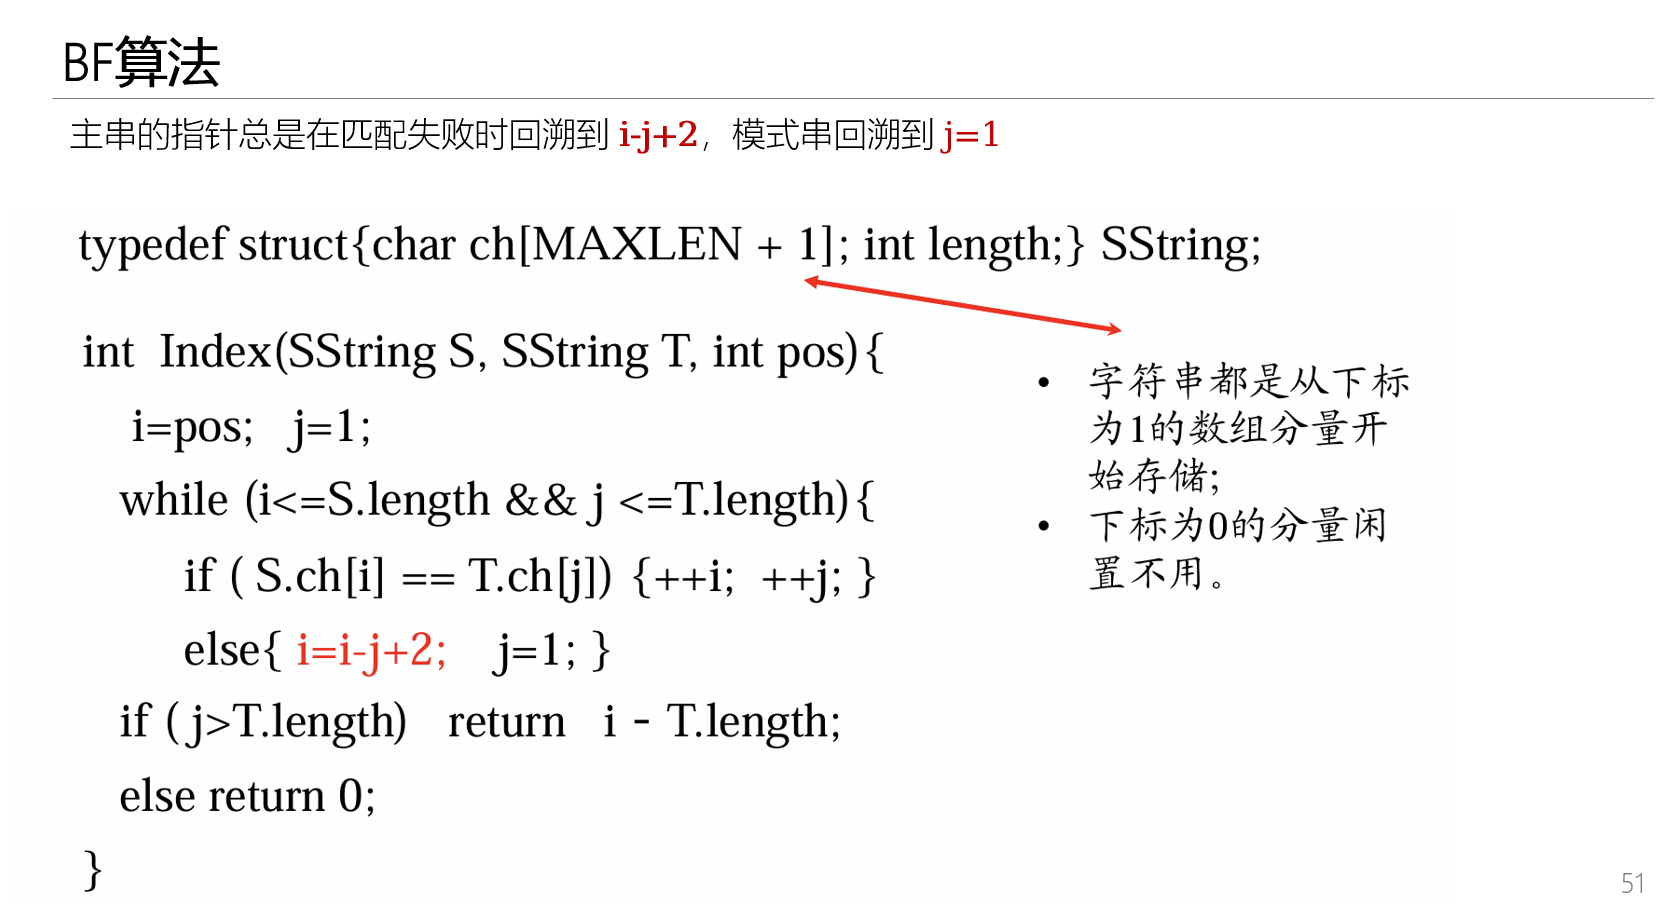
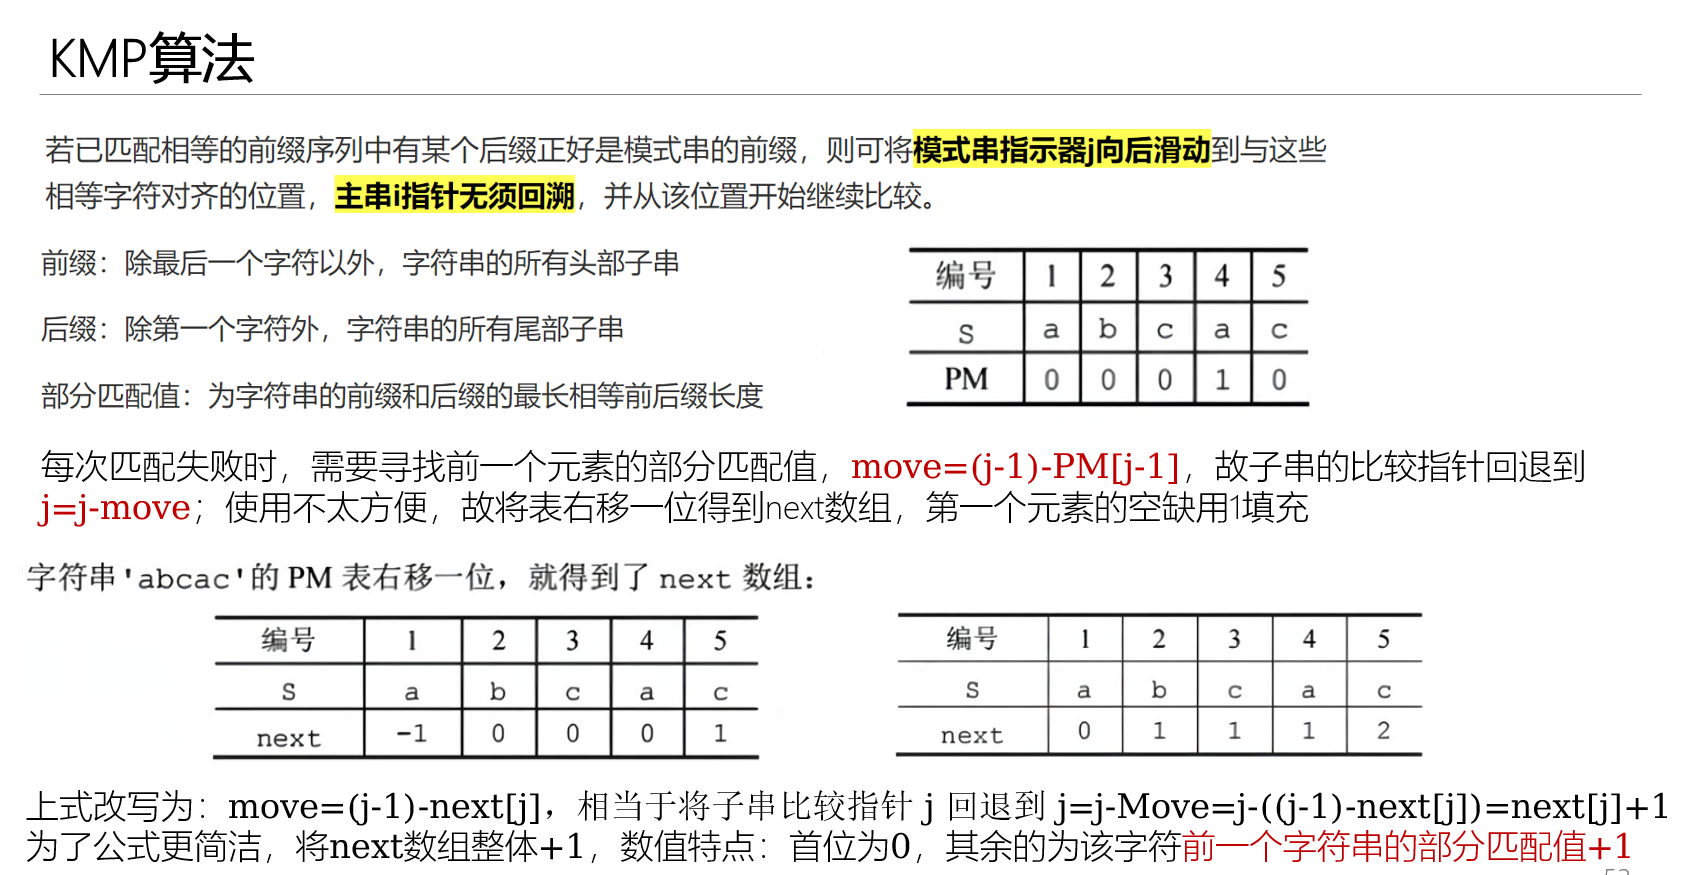
Week11: Week12: Week13: Week14: Week15: Week16: KMP算法 为了实现KMP算法,求出的nex数组会出现不同的情况。在我们的算法课中,认为旧教材中规定的nex数组是课程正确答案,而在有的同学的考研教辅中,nex数组不同。本文具体解释了这个问题,并给出了KMP的编程实现。
nex数组是什么? 概括地说,nex数组就是针对模式串p生成的一个数组,记录了公共前后缀长度——border长度,这个信息会被用来完成KMP算法中的回溯步骤,讲字符串匹配算法的时间复杂度降到O(n)
不同版本的nex数组差异在哪里?
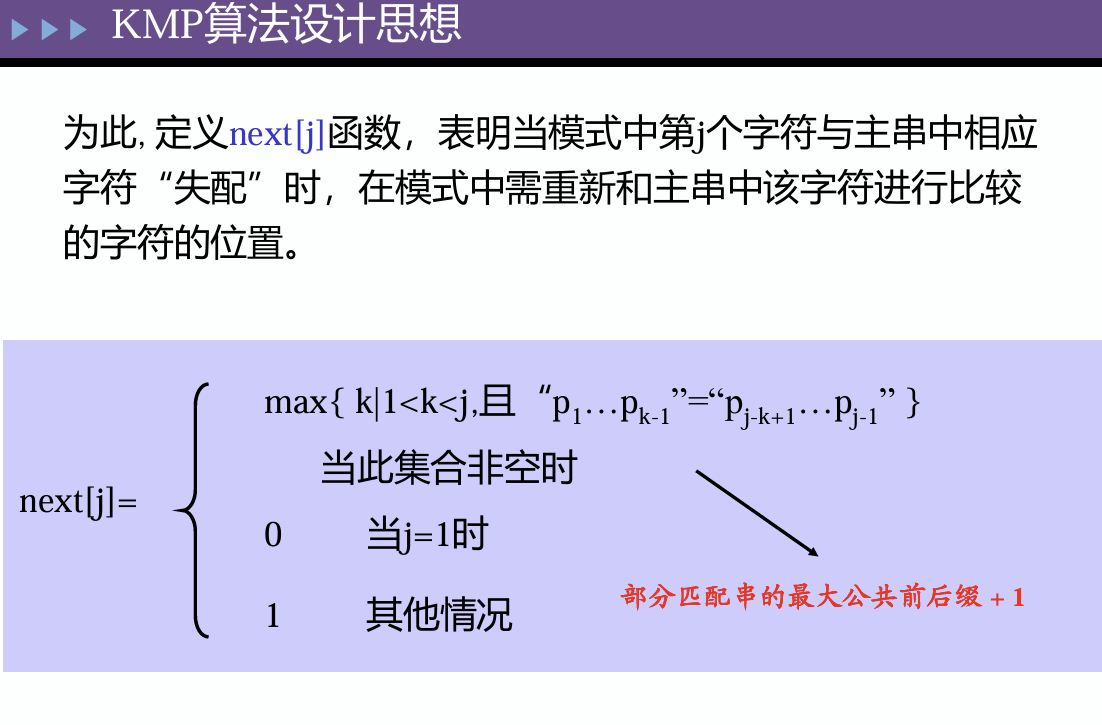
旧版本:nex[0]一定等于0 新版本:nex[0]一定等于0 其它情况:旧版nex[i]=新版nex[i]-1 笔算做题时要注意这种问题,旧版本的nex数组是不会有连续的0出现的,nex[i]=匹配串的最大公共前后缀 + 1
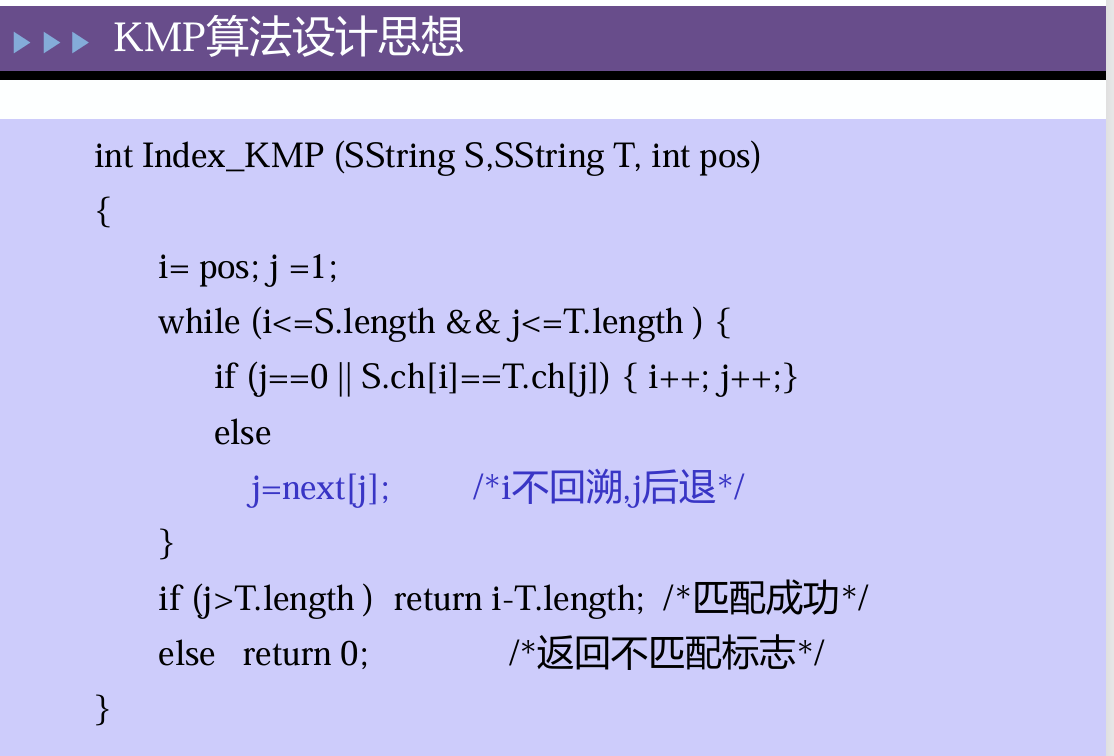
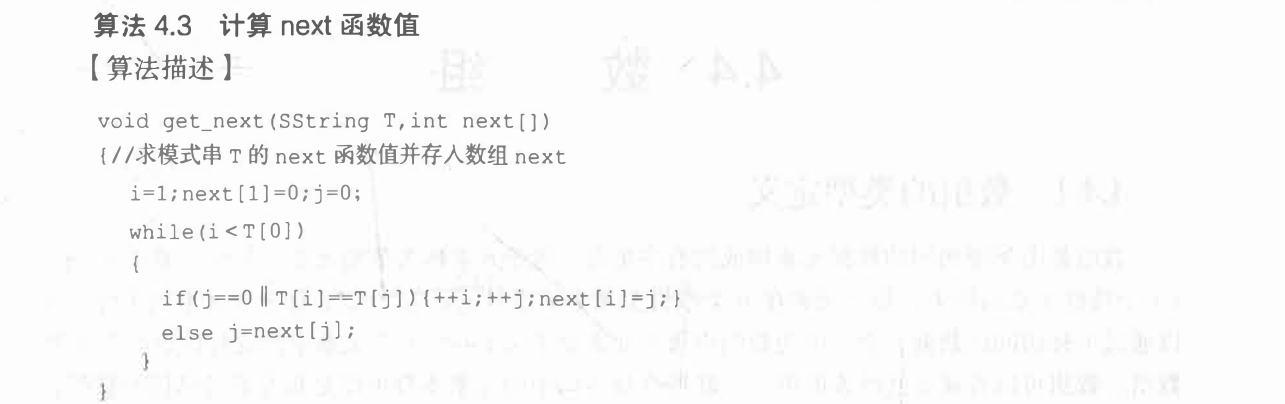
为什么会出现这样的差异? 这里我认为是因为在KMP算法实现中对特殊情况的不同处理办法,下面是旧版中next[j]的定义: 可以发现,当j=1时,nex[j]被强行规定为0,这时为了完成后续的KMP算法,0被赋予了特殊的含义——第一个字符就失配,此时如果回溯到下标为0的地方就会出错,因为在课程教材中,字符串的下标是从1开始的,下标为0的地方存储的是字符串长度。 但是,如果此时回溯到下标为1的地方,就会陷入死循环 为什么会陷入死循环? 我们知道,在KMP算法中,要匹配的字符串s的下标指针i是不会倒退的,那这时如果第一个字符匹配失败还讲j回溯到下标1(当前就在下标1),就会重复这个比较过程一直循环。 这就启发这里的算法实现必须对nex[1]进行特殊处理。书中的KMP实现如下:
求nex数组(求border) 不同的KMP代码实现对应了不同的nex数组,同时也对应了不同的数组下标使用方式。原理相同,但是不可混用。 1 2 3 4 5 6 7 8 9 0 ]=nex[1 ]=0 ;for (int i=2 ,j=0 ;i<=m;i++)while (j&&p[i]!=p[j+1 ]) j=nex[j];if (p[i]==p[j+1 ]) j++;
KMP算法模板(C++) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 #include <bits/stdc++.h> using namespace std;const int N = 1e6 + 9 ;char s[N],p[N];int nex[N];int main () sync_with_stdio (0 ),cin.tie (0 ),cout.tie (0 );1 ;int m = strlen (p + 1 );1 ;int n = strlen (s + 1 );0 ] = nex[1 ] = 0 ;for (int i = 2 ,j = 0 ;i <= m;i ++)while (j && p[i] != p[j + 1 ])j = nex[j];if (p[i] == p[j + 1 ])j ++;int ans = 0 ;for (int i = 1 ,j = 0 ;i <= n;i ++)while (j && s[i] != p[j + 1 ])j = nex[j];if (s[i] == p[i + 1 ])j ++;if (j == m)ans ++;return 0 ;
2025/1/1: 上述问题其实我没有弄清楚,直到昨天听了数据结构的期末复习讲解。引用ppt,感觉这个解释清楚了。
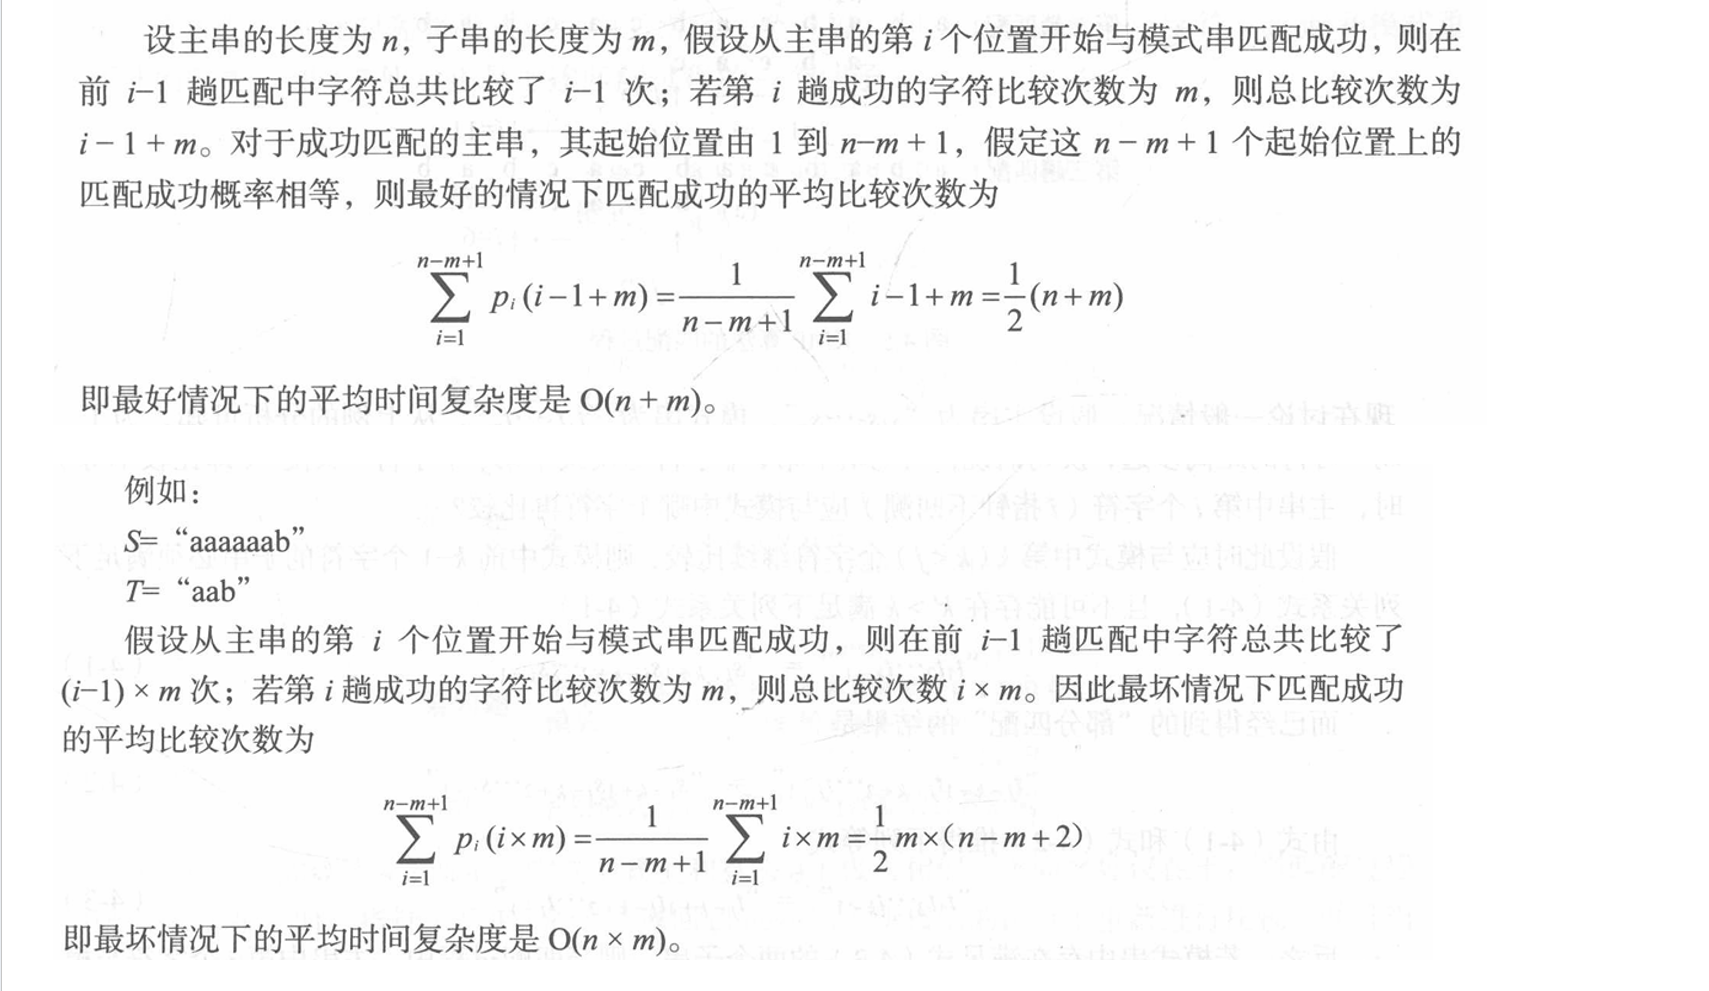
KMP 的时间复杂度分析
二分法 二分法太常用了,学了又忘,忘了再来吧。
整数集合上二分 二分难在版本太多了,用起来总是让人头晕,比如: 又如:
1 2 3 4 5 6 7 8 9 10 int Binary_search2 (int l,int r) while (l <= r)int mid=(l+r)/2 ;if (a[mid]>=x) r=mid-1 ;else l=mid+1 ;return mid;
还有:
1 2 3 4 5 6 7 8 9 10 11 int Binary_search3 (int l,int r) while (l < r)int mid=(l+r)/2 ;if (a[mid]>x) l=mid+1 ;else if (a[mid] < x)r=mid-1 ;else break ;return mid;
为什么会出现这么多版本方法? 究其原因,是因为: 首先,二分法是一种不断逼近的算法,不断在实数域上逼近一个答案,然而,由于计算机的整除是下取整的,这就会导致这个算法在实现上并不会尽如人意。所有的版本都是在避免一种情况:死循环。 三个版本都是对同一种情况的不同解决办法,下面逐一考虑:
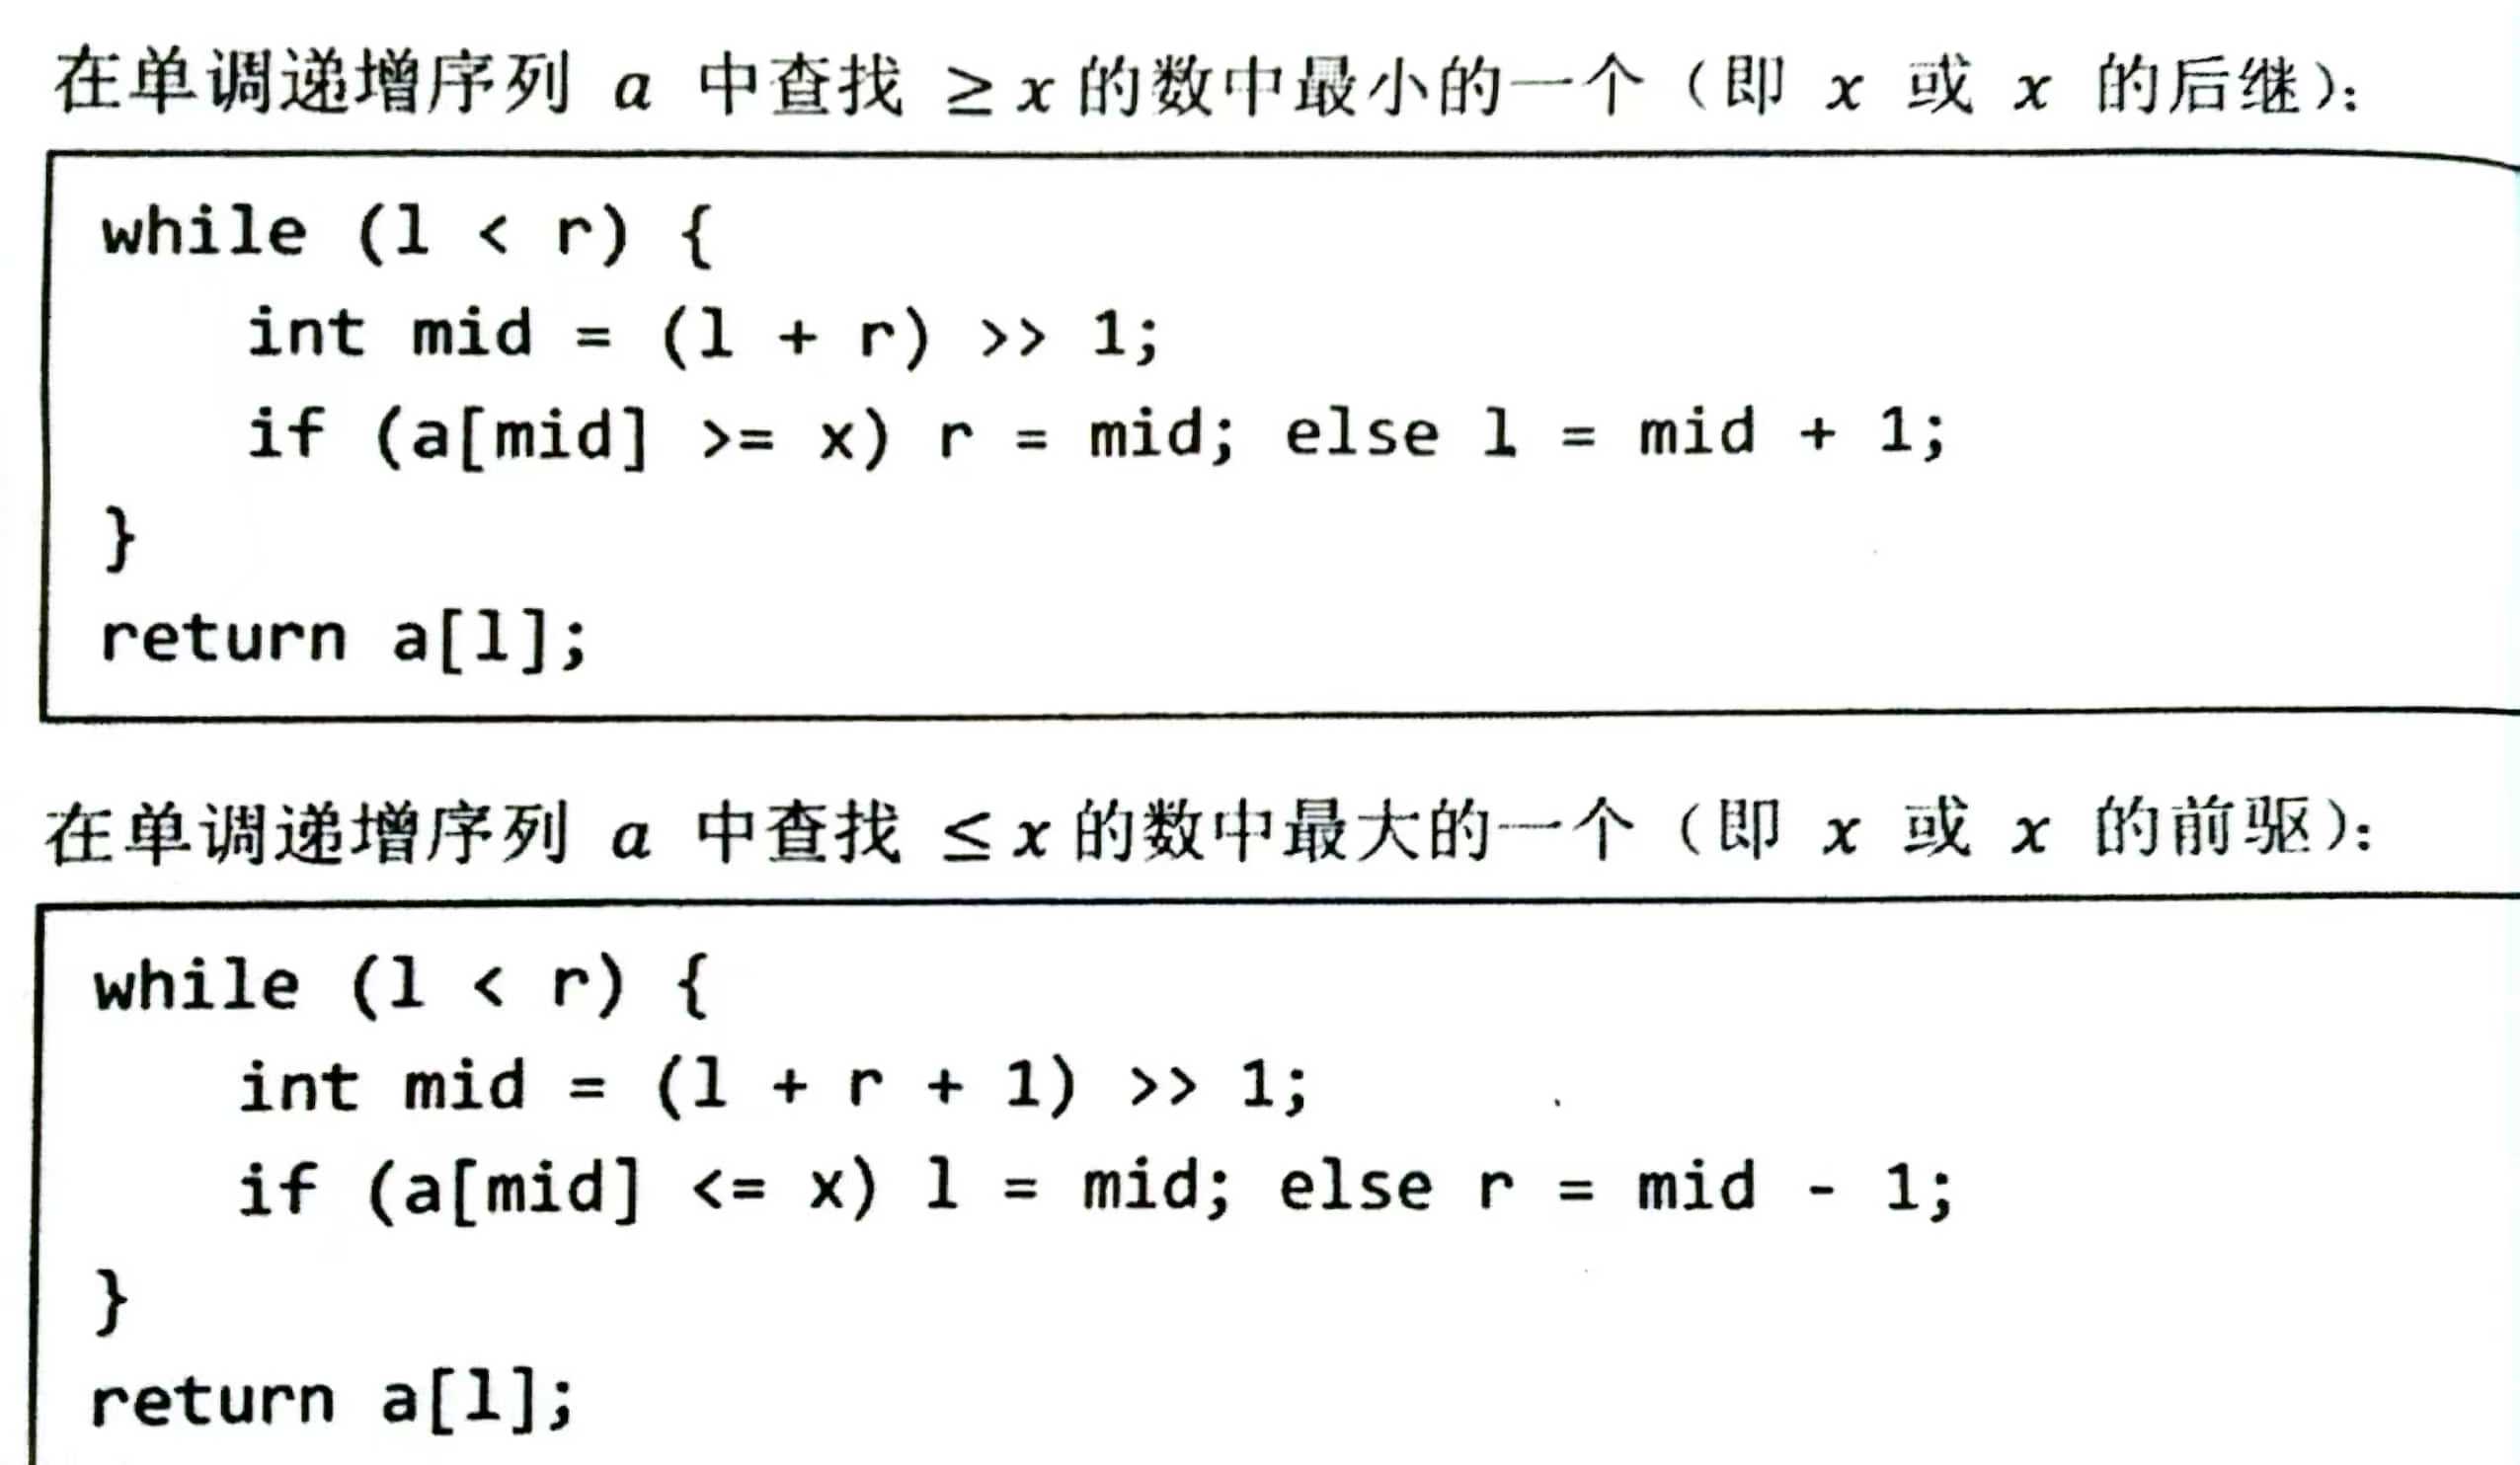
考虑Binary_search1: 这个代码不对称?求大于等于和求小于等于写法不同?为什么? 感觉这个版本是最难的,但是,理解这个代码为什么会这样写,是对彻底理解二分死循环帮助最大的。
自然地,二分,mid=(l+r)/2,要取正中间才对(理论上),可是实际上是这样吗? 考虑这种情况:
1 2 3 4 while (l < r){int mid = (l + r) >> 1 ;if (a[mid] <= x)l = mid;else r = mid - 1 ;
l = r - 1
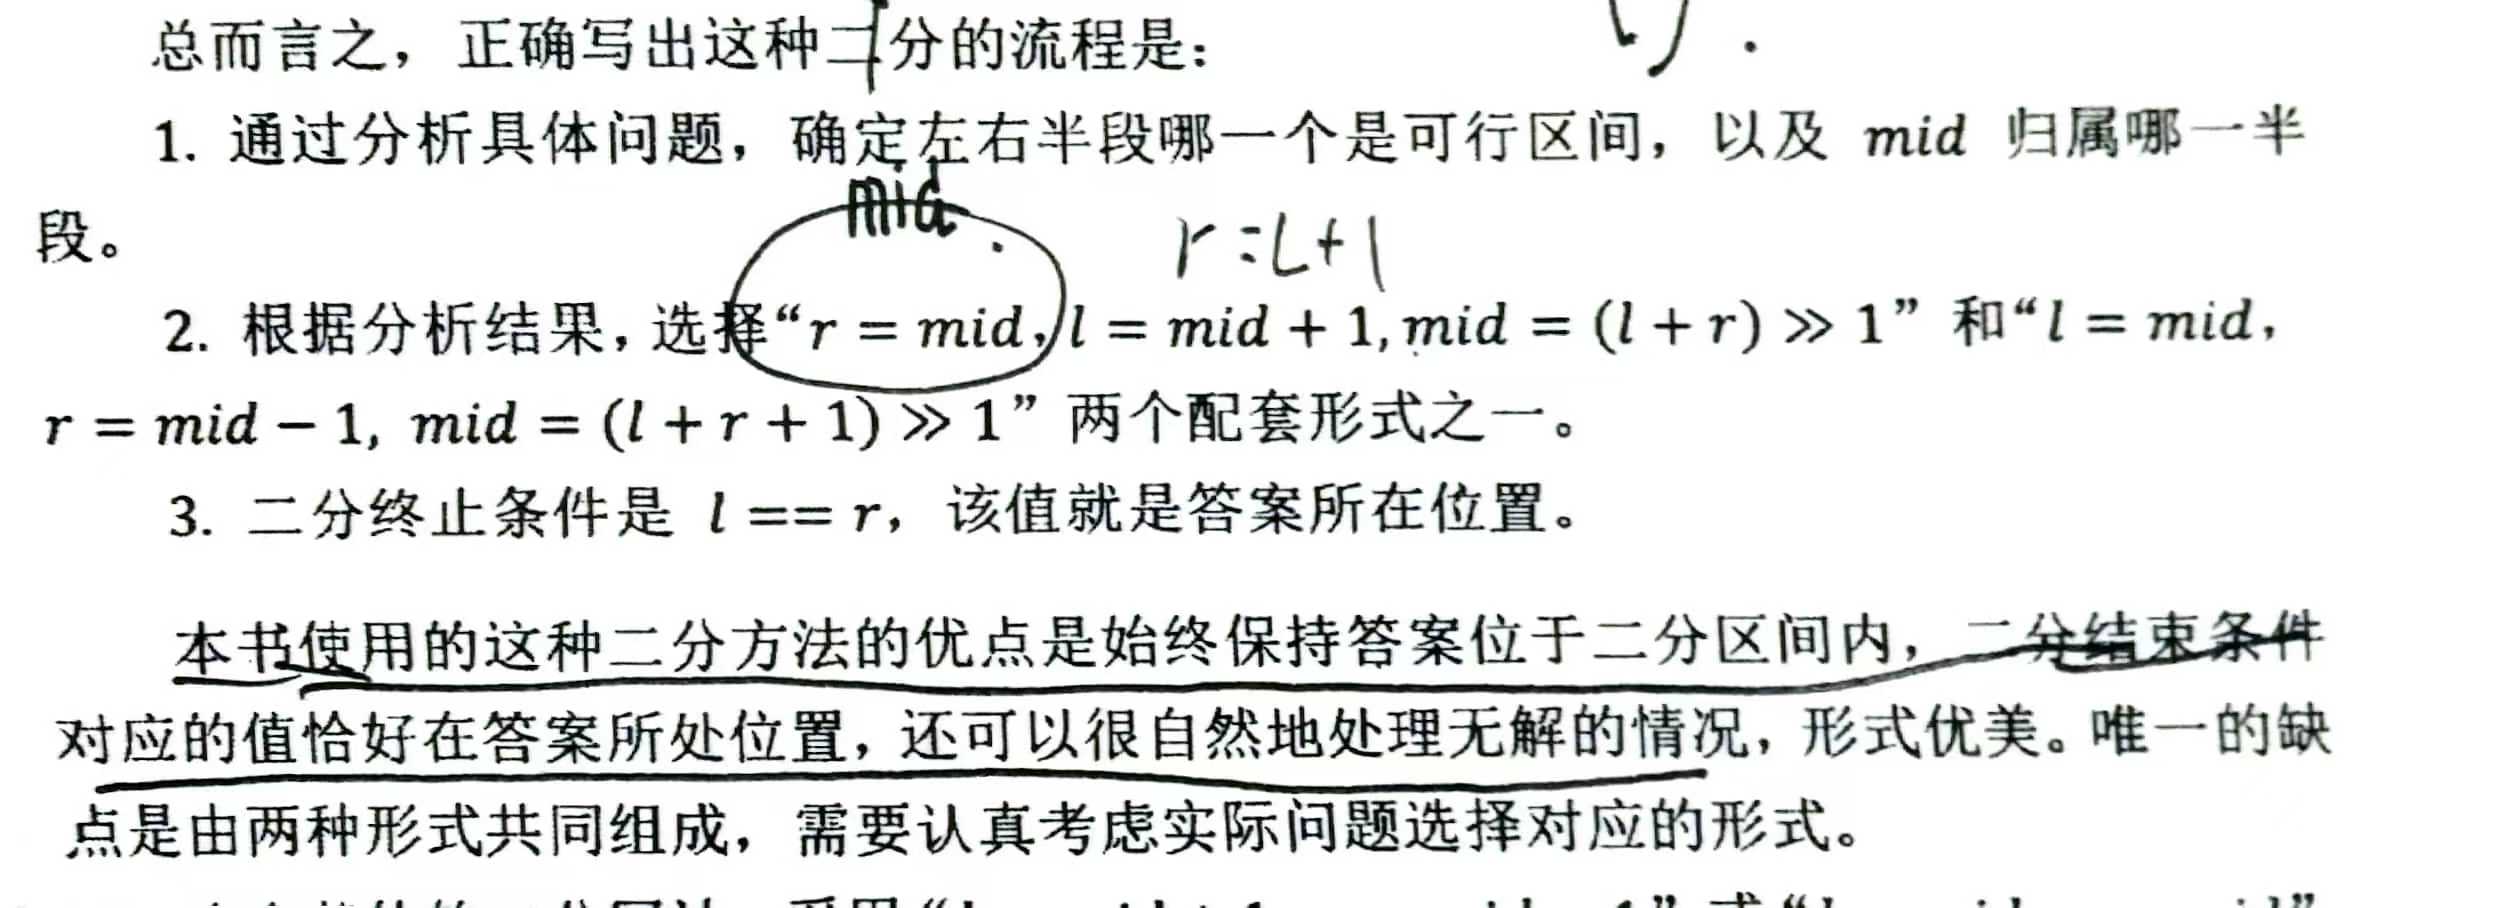
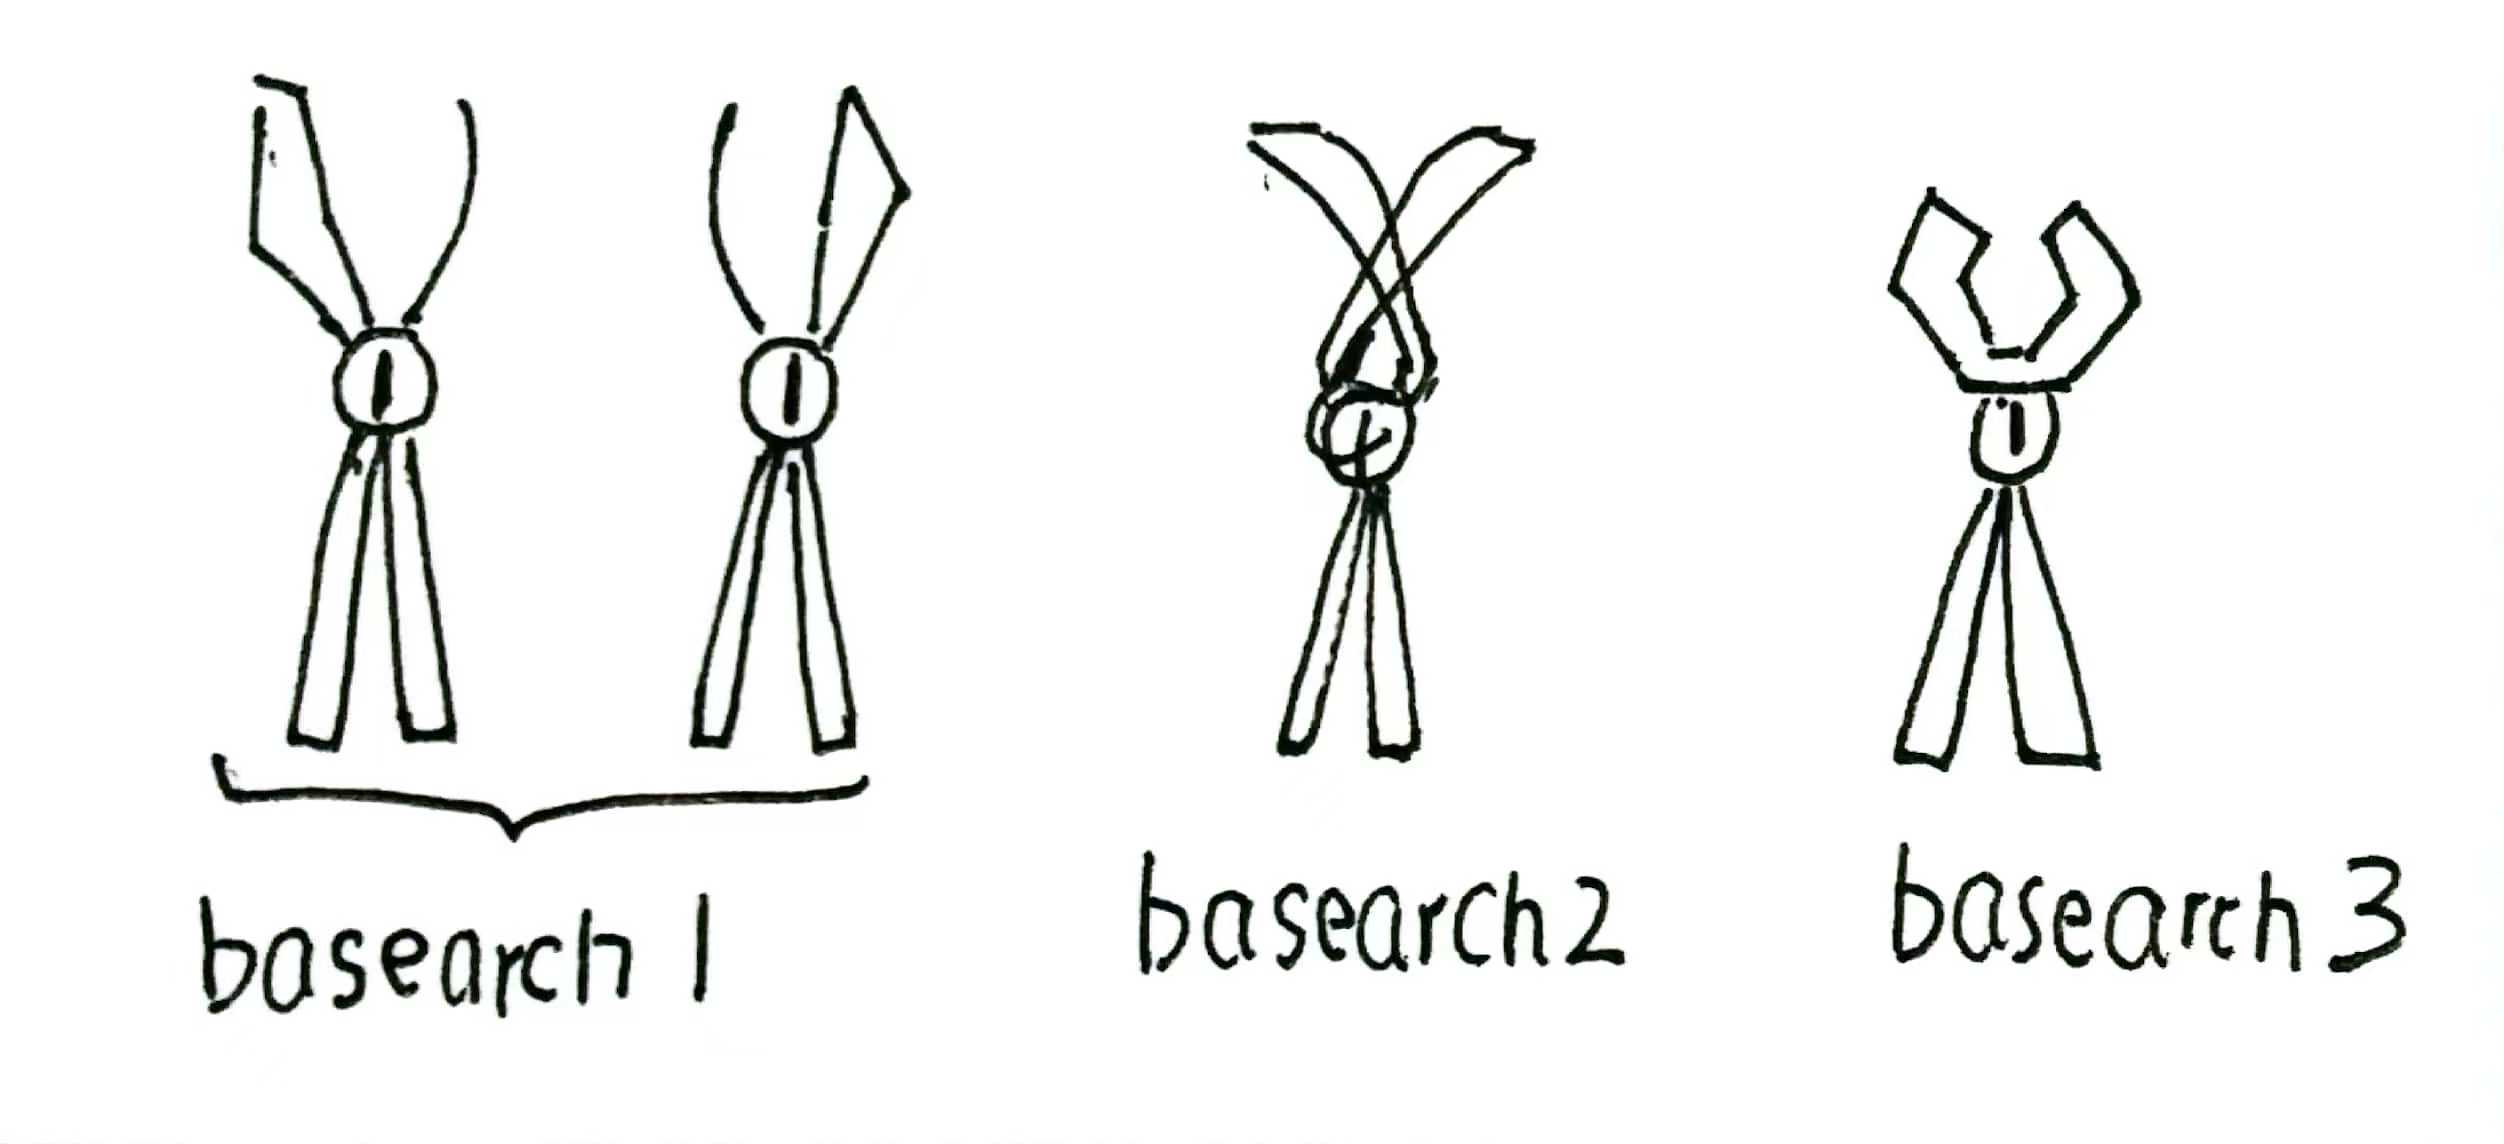
那怎么改呢,让mid=(l+r+1)/2,变成了上取整,于是就有了Binary_search1 那怎么改呢,让循环条件l<=r,l=mid-1,让两个指针错过后取中间,于是就有了Binary_search2 那怎么改呢,让循环条件不变,单独考虑a[mid]=x时,再加一个else分支判断一下,于是就有了Binary_search3 没明白? 可是现在还是没明白为什么b1要分情况两种写法,而b2,b3只需一种写法即可。 打个比方,三个方法都在设计夹子夹住答案,而b1就是设计了一把不对称的夹子,或左大右小(下取整),或左小右大(上取整) 另外两种夹子写起来是对称的,所以省心些。
还是没明白? 可是现在还没明白为什么一会上取整,一会又下取整? 其实二分法本身就不对称,答案是一个整数,要么从左边趋近它,要么从右边趋近它,这就要考虑不同情况。
就是想用basesearch1? 《算法竞赛-进阶指南》给出了指导意见:
例题:线性表整数二分查找
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 #include <bits/stdc++.h> using namespace std;#define MAXSIZE 10 #define NotFound 0 typedef int ElementType;typedef int Position ;typedef struct LNode *List;struct LNode List CreatList () ;Position BinarySearch (List ,ElementType X) ;List CreatList () malloc (sizeof (struct LNode));-1 ;return L;Position BinarySearch (List L,ElementType X) int left = 1 ;int right = L->Last;while (left < right)int center = (left+right) / 2 ;if (X > L->Data[center])1 ;else if (X < L->Data[center])1 ;else {return center;return NotFound;int main () CreatList ();for (int i = 1 ;i < 4 ;++ i)2 * i - 1 ;3 ;scanf ("%d" ,&X);BinarySearch (L,X);printf ("%d\n" ,P);return 0 ;
综上所述: 其实二分只有一种,每次写的时候想象你设计的夹子的样子,脑补那个死循环的样子,不变应万变了。 好了,现在理解了整数二分,那么二分答案、实数二分、三分……也就不难了,后续在本文中补齐。
队列 先进先出的数据结构,很常用
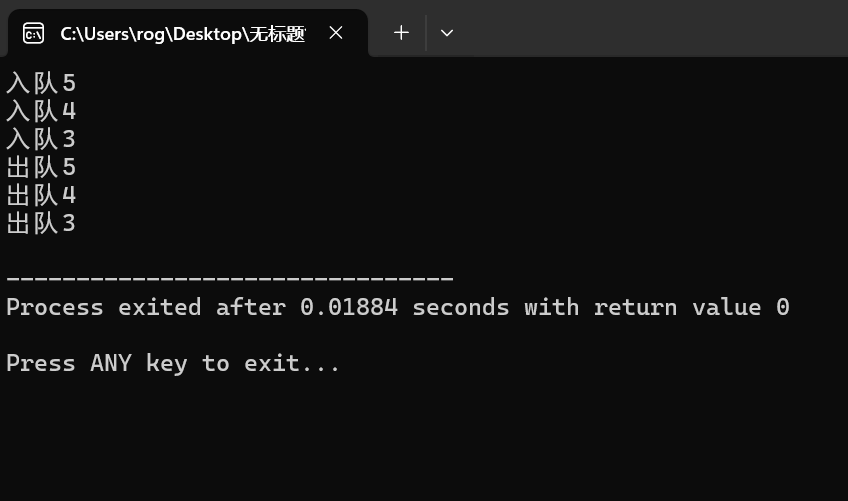
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 #include <iostream> #include <queue> using namespace std;int main () int > Q;printf ("入队5\n" ); push (5 );printf ("入队4\n" ); push (4 );printf ("入队3\n" ); push (3 );printf ("出队%d\n" ,Q.front ());pop ();printf ("出队%d\n" ,Q.front ());pop ();printf ("出队%d\n" ,Q.front ());pop ();return 0 ;
举个栗子:
https://www.luogu.com.cn/problem/P1540
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 #include <bits/stdc++.h> using namespace std;int m,n;int countt = 0 ;int que[10000 ];int head;int tail;int ,int >mapp;int main () 0 ;for (int i = 1 ;i <= n;++ i)int c;cin >> c ;if (mapp.count (c))continue ;if (tail - head + 1 <= m)1 ;else {1 ;erase (que[head]);return 0 ;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 #include <stdio.h> #include <malloc.h> #define MaxSize 100 typedef int ElementType;typedef struct QNode *Queue;struct QNode {int front; int rear; Queue CreateQueue () ; void AddQ (Queue Q,ElementType item) int IsFull (Queue Q) ElementType DeleteQ (Queue Q) ; int IsEmpty (Queue Q) Queue CreateQueue () {malloc (sizeof (struct QNode));-1 ;-1 ;return Q;int IsFull (Queue Q) return ((Q->rear+1 ) % MaxSize == Q->front);void AddQ (Queue Q,ElementType item) if (IsFull (Q)){printf ("队列满" );return ;else { +1 ) % MaxSize;int IsEmpty (Queue Q) return (Q->front == Q->rear);ElementType DeleteQ (Queue Q) {if (IsEmpty (Q)){printf ("队列空" );return 0 ;else {+1 ) % MaxSize;return Q->Data[Q->front];int main () CreateQueue ();AddQ (Q,3 );printf ("3入队\n" );AddQ (Q,5 );printf ("5入队\n" );AddQ (Q,11 );printf ("11入队\n" );printf ("%d出队\n" ,DeleteQ (Q));printf ("%d出队\n" ,DeleteQ (Q));return 0 ;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 #include <stdio.h> #include <malloc.h> typedef int ElementType;typedef struct QNode *Queue;struct Node {struct Node *Next;struct QNode {struct Node *rear; struct Node *front; Queue CreateQueue () ; void AddQ (Queue Q,ElementType item) ElementType DeleteQ (Queue Q) ; int IsEmpty (Queue Q) Queue CreateQueue () {malloc (sizeof (struct QNode));NULL ;NULL ;return Q;int IsEmpty (Queue Q) return (Q->front == NULL );void AddQ (Queue Q,ElementType item) struct Node *node;struct Node *)malloc (sizeof (struct Node));NULL ;if (Q->rear==NULL ){ else { ElementType DeleteQ (Queue Q) {struct Node *FrontCell;if (IsEmpty (Q)){printf ("队列空" );return 0 ;if (Q->front == Q->rear){ NULL ; else {free (FrontCell);return FrontElem;int main () CreateQueue ();printf ("入队5\n" ); AddQ (Q,5 );printf ("入队4\n" ); AddQ (Q,4 );printf ("入队3\n" ); AddQ (Q,3 );printf ("出队%d\n" ,DeleteQ (Q));printf ("出队%d\n" ,DeleteQ (Q));printf ("出队%d\n" ,DeleteQ (Q));printf ("%d\n" ,DeleteQ (Q));return 0 ;
链表 还记得他怎么说?“更重要的是,知道如何调整这样一种结构”
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 #include <bits/stdc++.h> using namespace std;typedef int ElementType;typedef struct Node *PtrToNode;struct Node {typedef PtrToNode List ;List Read () ;void Print (List L) List Merge (List L1,List L2) ;int main () Read ();Read ();Print (L1);Print (L2);Merge (L1,L2);Print (L);Print (L1);Print (L2);return 0 ;List Read () malloc (sizeof (struct Node));int n;cin >> n;for (int i = 1 ;i <= n;++ i)int data;scanf ("%d" ,&data);malloc (sizeof (struct Node));NULL ;return head;void Print (List L) if (t==NULL )printf ("NULL" );for (;t;t=t->Next)printf ("%d " ,t->Data);printf ("\n" );List Merge (List L1,List L2) malloc (sizeof (struct Node));while (tmpL1 && tmpL2)if (tmpL1->Data < tmpL2->Data){else {if (tmpL1)if (tmpL2)NULL ;NULL ;return head;
树(上) 后来才明白,为什么非要有树这种东西。 树的遍历,前序、中序、后序、层序,非递归,递归
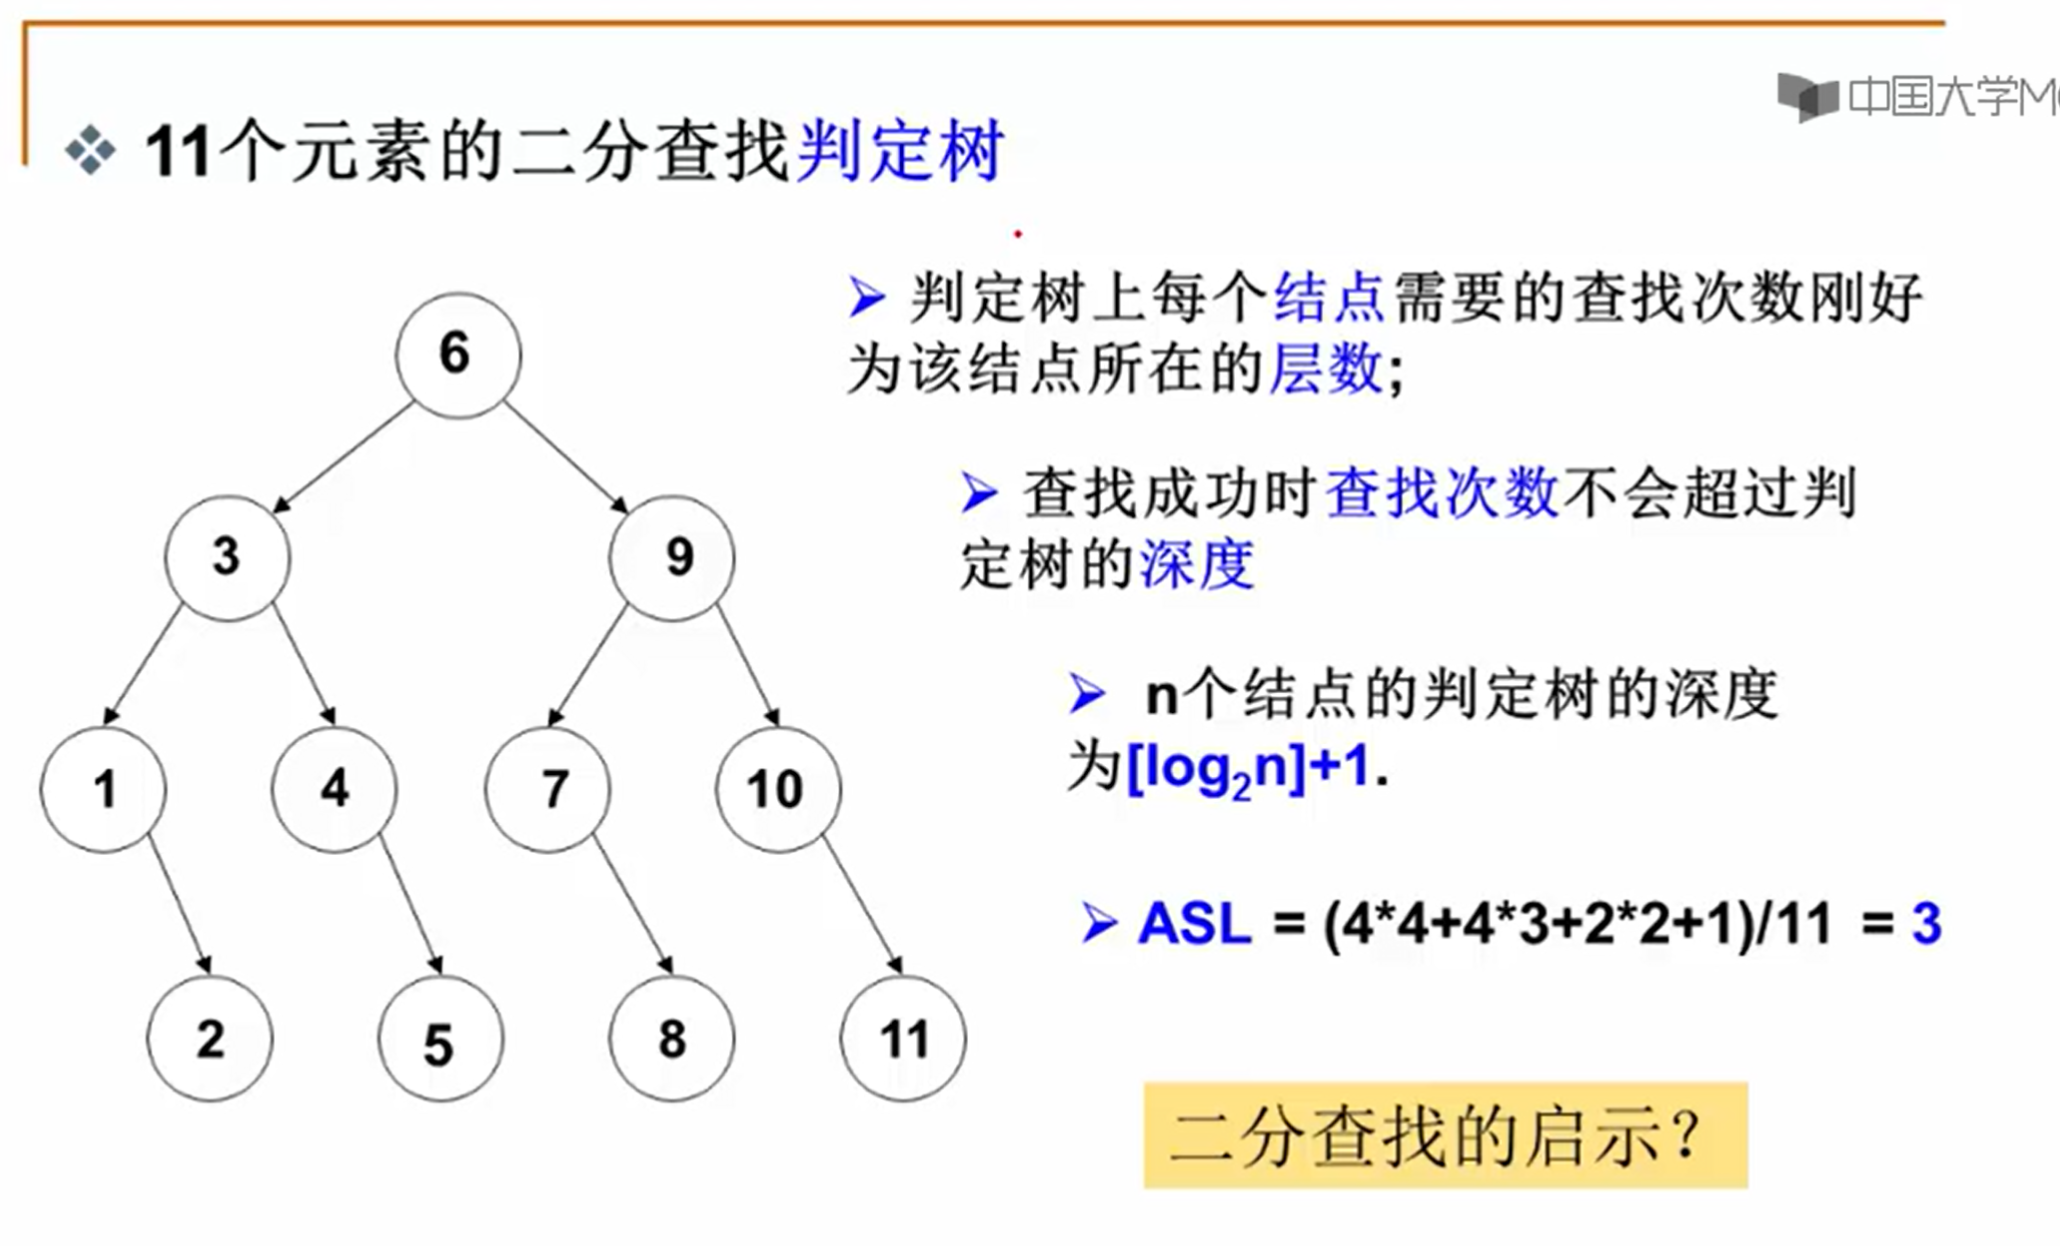
引入:二分查找
“从这里面我们可以看到,由于我们在数组里面,对于我们要查找的元素,进行了有序化的一种组织,使得我们的查找过程是按照固定的顺序,或者说,是按照事先定义好的顺序来进行的。” 而这个顺序呢,是形成我们所说的类似树这样的一个结构 那反过来说,能不能把数据不一定放在数组? 我就按照这样的一个层次化的结构来存放数据,是不是也会达到二分查找一样的效果?”
这就顺理成章地引入了树这种数据结构,用树的结构存储数据。 使得插入、查找、删除等等操作更加方便。 这样一来,动态查找问题也得到了解决!
树的定义 ……
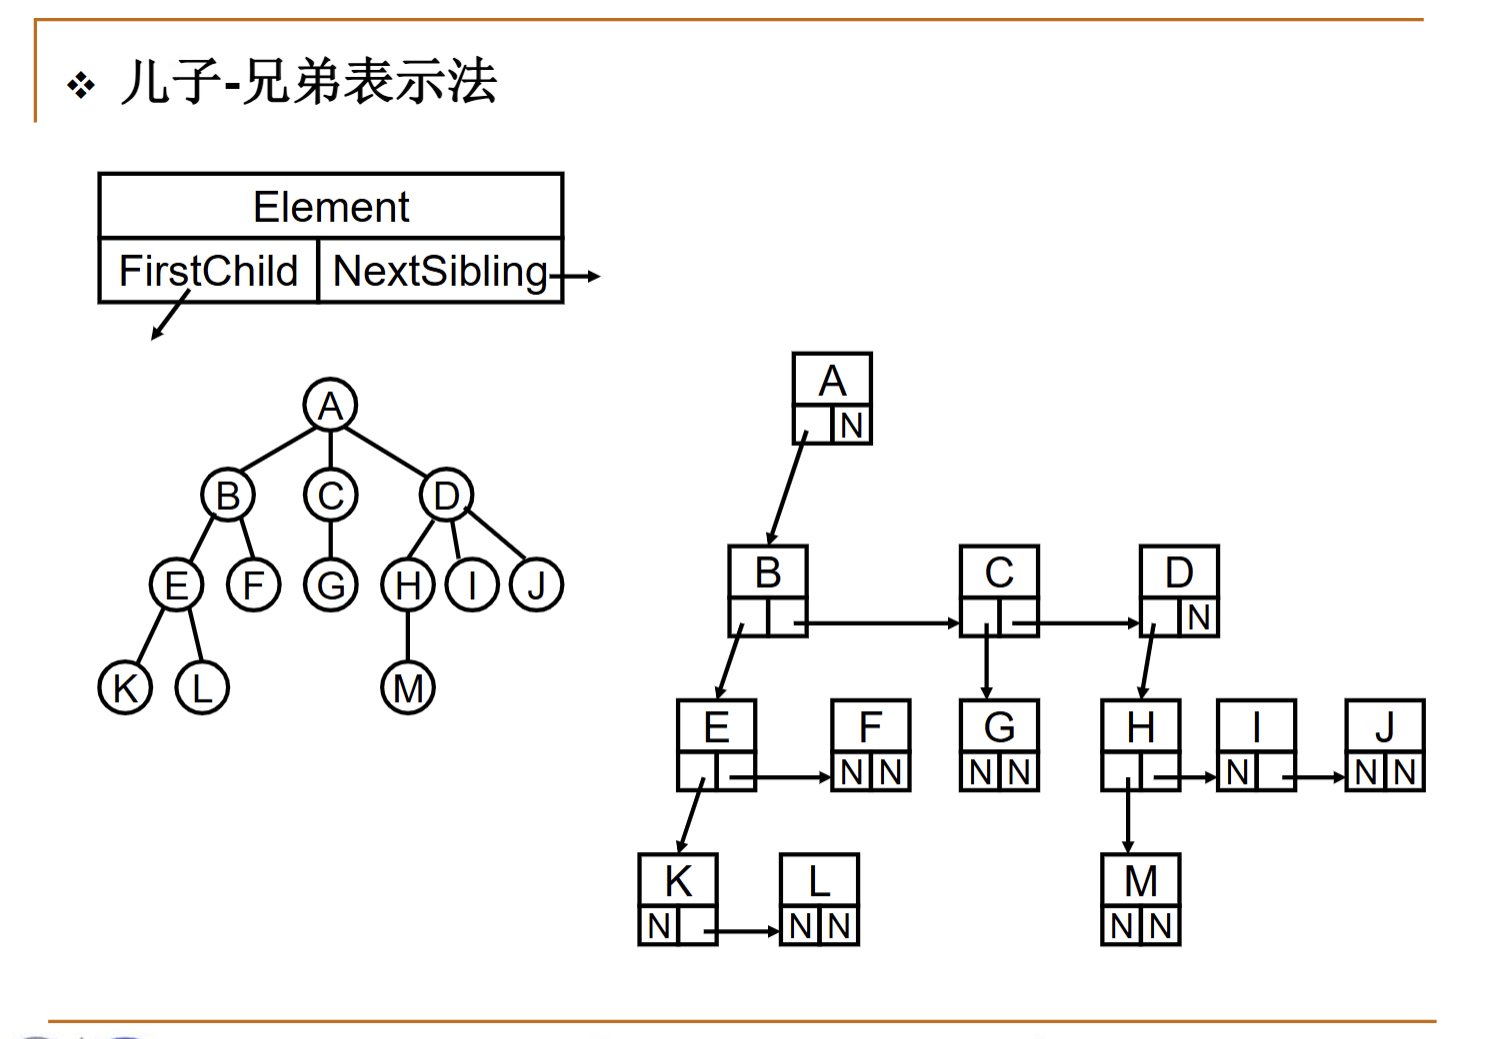
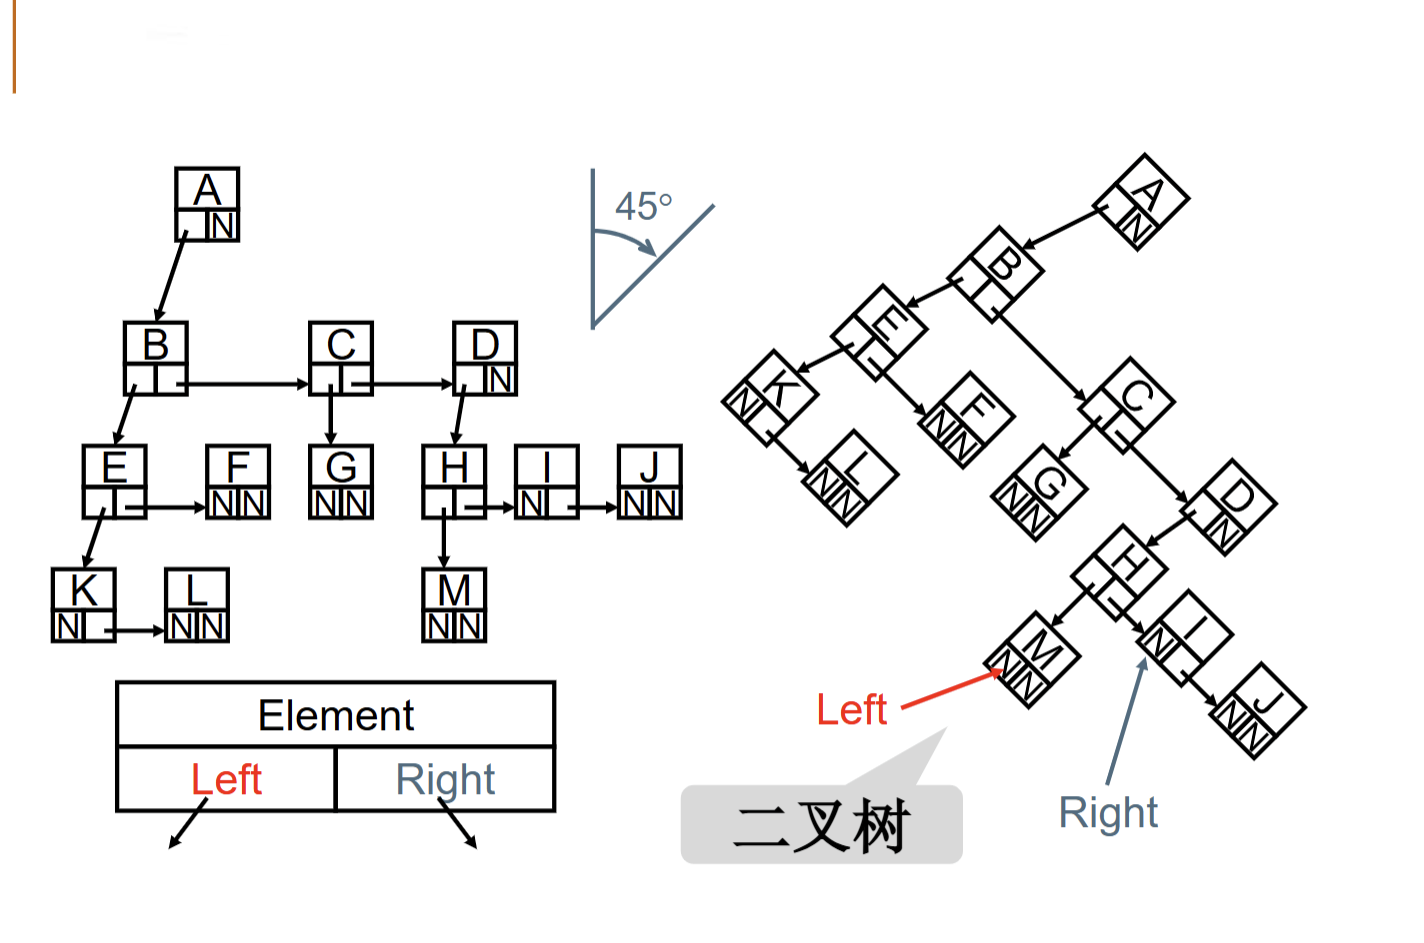
树的表示 Q:每个结点设计几个指针域呢?事先不知道它有几个子节点,那怎么办? A:每个结点都留5个吧,这就能存下了,但是造成了大量的空间浪费。 A:儿子-兄弟表示法,只用两个指针域!
PS:儿子兄弟表示法如何实现呢?
1.链式前向星,即数组模拟链表 2.邻接矩阵,用C++的二维向量实现 3.真链表
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 228 229 230 231 232 233 234 235 236 237 238 239 240 241 242 243 244 245 246 247 248 249 250 251 252 253 254 255 256 257 258 259 #include <stdio.h> #include <malloc.h> #include <vector> #include <queue> #include <algorithm> typedef struct TreeNode *BinTree;struct TreeNode {int Data; BinTree CreatBinTree () ; bool IsEmpty (BinTree BT) void PreOrderTraversal (BinTree BT) void InOrderTraversal (BinTree BT) void PostOrderTraversal (BinTree BT) using namespace std;typedef struct SNode *Stack;struct SNode {Stack CreateStack () ; int IsEmpty (Stack S) void Push (Stack S,BinTree item) BinTree Pop (Stack S) ; Stack CreateStack () {malloc (sizeof (struct SNode));NULL ;return S;int IsEmpty (Stack S) return (S->Next == NULL );void Push (Stack S,BinTree item) malloc (sizeof (struct SNode));BinTree Pop (Stack S) {if (IsEmpty (S)){printf ("堆栈空" );return 0 ;else {free (First); return TopVal;BinTree Insert (int Data) {malloc (sizeof (struct TreeNode));NULL ;NULL ;return BT;BinTree CreatBinTree () {malloc (sizeof (struct TreeNode));1 ;Insert (2 );Insert (3 );Insert (4 );Insert (6 );Insert (5 );Insert (7 );Insert (9 );Insert (8 );return BT;void PreOrderTraversal (BinTree BT) CreateStack (); while (T || !IsEmpty (S)){ while (T){ Push (S,T); printf ("%d" ,T->Data); if (!IsEmpty (S)){ Pop (S); void InOrderTraversal (BinTree BT) CreateStack (); while (T || !IsEmpty (S)){ while (T){ Push (S,T); if (!IsEmpty (S)){ Pop (S); printf ("%d" ,T->Data); void PostOrderTraversal (BinTree BT) CreateStack (); Push (S,T);while (!IsEmpty (S)){ Pop (S);push_back (T);if (T->Left)Push (S,T->Left);if (T->Right)Push (S,T->Right);reverse (v.begin (),v.end ()); for (int i=0 ;i<v.size ();i++)printf ("%d" ,v[i]->Data);void LevelOrderTraversal (BinTree BT) if (!BT)return ;push (BT); while (!q.empty ()){front (); pop (); printf ("%d" ,T->Data);if (T->Left)push (T->Left);if (T->Right)push (T->Right);void FindLeaves (BinTree BT) if (BT){if ( !BT->Left && !BT->Right)printf ("%d" ,BT->Data); FindLeaves (BT->Left); FindLeaves (BT->Right); int GetHeight (BinTree BT) int hl,hr,maxh;if (BT){GetHeight (BT->Left); GetHeight (BT->Right); return maxh+1 ; else return 0 ;int main () CreatBinTree ();printf ("先序遍历:" );PreOrderTraversal (BT);printf ("\n中序遍历:" );InOrderTraversal (BT);printf ("\n后序遍历:" );PostOrderTraversal (BT);printf ("\n层次遍历:" );LevelOrderTraversal (BT);printf ("\n输出叶子结点:" ); FindLeaves (BT);printf ("\n输出树的高度:%d" ,GetHeight (BT));return 0 ;
树(中)
引例:实现一个按字典序的存着12个月的英文单词的二叉搜索树 1 2 3 4 5 char * months[12 ] = { "January" , "February" , "March" , "April" , "May" , "June" , "July" , "August" , "September" , "October" , "November" , "December"
综合了前边所有的前置知识,还用到了C语言相关基础。 避坑!:第一个指针T必须事先赋值为NULL,不然会出现一个segmentation fault-段错误,指到了不该指的地方。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 #include <stdio.h> #include <stdlib.h> #include <string.h> typedef struct TreeNode {char *s; struct TreeNode *Left ;struct TreeNode *Right ;TreeInsert (char *s, BinTree *T) { if (T == NULL ) { malloc (sizeof (BinTree)); if (T == NULL ) { printf ("Memory allocation failed\n" ); exit (EXIT_FAILURE); NULL ; else if (strcmp (s, T->s) < 0 ) { else if (strcmp (s, T->s) > 0 ) { return T; void InOrderTraversal (BinTree *T) { if (T != NULL ) { printf ("%s\n" , T->s); void FreeTree (BinTree *T) { if (T != NULL ) { free (T->s); free (T); int main () { char * months[12 ] = { "January" , "February" , "March" , "April" , "May" , "June" , "July" , "August" , "September" , "October" , "November" , "December" NULL ; for (int i = 0 ; i < 12 ; i++) { printf ("Inorder traversal of BST:\n" ); return 0 ;
可以试试把递归和非递归的各种遍历都试试。
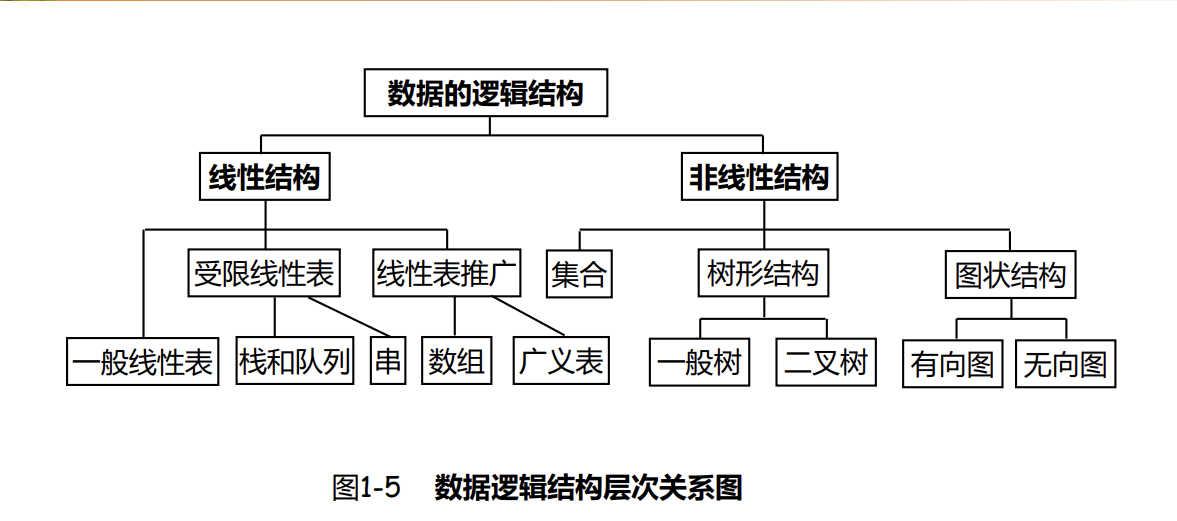
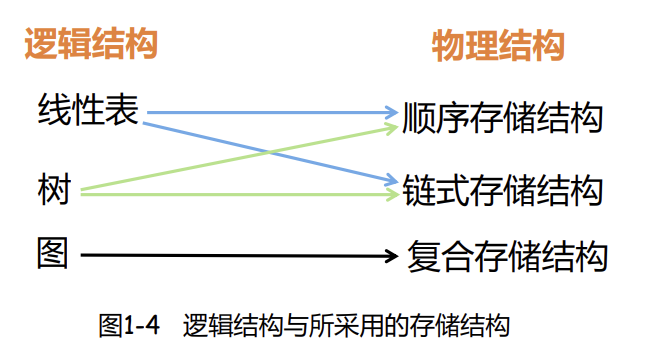
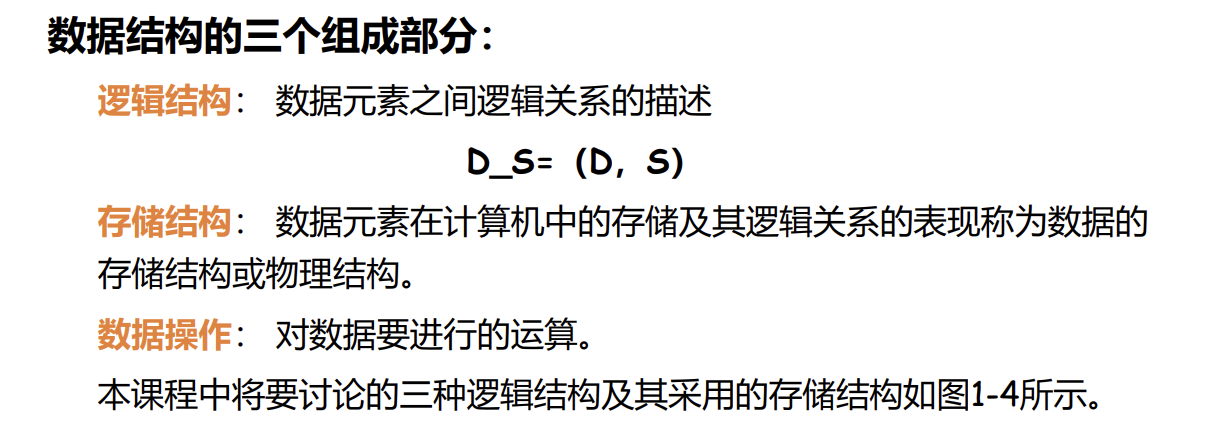
线性表 线性表的数组和链表实现,以及线性表拓展。
这里第一个难点就是理解指针是什么,指针是什么呢? 线性表,像数组吧,数组和链表是它的两种实现方式。 数组存:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 #include <stdio.h> #include <malloc.h> #define MAXSIZE 100 typedef int ElementType; typedef struct LNode *List; struct LNode {int Last; List MakeEmpty () ; int Find (ElementType X,List L) void Insert (ElementType X,int i,List L) void Delete (int i,List L) ElementType FindKth (int K,List L) ; int Length (List L) List MakeEmpty () {malloc (sizeof (struct LNode));-1 ;return L;int Find (ElementType X,List L) int i=0 ;while (i <= L->Last && L->Data[i] != X) if (L->Last < i) return -1 ; else return i;void Insert (ElementType X,int i,List L) int j;if (L->Last == MAXSIZE-1 ){ printf ("表满" );return ;if (i < 0 || L->Last+1 < i){ printf ("位置不合法" );return ;for (j=L->Last;j>=i;j--) +1 ] = L->Data[j]; return ;void Delete (int i,List L) int j;if (i < 0 || L->Last <i){ printf ("L->Data[%d]不存在元素" ,i);return ;for (j=i+1 ;j<=L->Last;j++) -1 ] = L->Data[j];return ;ElementType FindKth (int K,List L) {if (K < 0 || L->Last < K){ printf ("L->Data[%d]不存在元素" ,K);return ;return L->Data[K];int Length (List L) return L->Last+1 ;int main () int i=0 ;MakeEmpty ();Insert (11 ,0 ,L);printf ("在线性表L-Data[0]插入11\n" );Insert (25 ,0 ,L);printf ("在线性表L-Data[0]插入25\n" );Insert (33 ,0 ,L);printf ("在线性表L-Data[0]插入33\n" );Insert (77 ,0 ,L);printf ("在线性表L-Data[0]插入77\n" );printf ("此时的线性表为:" ); for (i=0 ;i<Length (L);i++)printf ("%d " ,L->Data[i]);printf ("\n" );printf ("查找值为12的下标是:%d\n" ,Find (12 ,L));printf ("下标为3的线性表的值是:%d\n" ,FindKth (3 ,L));Delete (2 ,L);printf ("删除线性表中下标为2的元素\n" );Delete (2 ,L);printf ("删除线性表中下标为2的元素\n" );printf ("此时的线性表为:" ); for (i=0 ;i<Length (L);i++)printf ("%d " ,L->Data[i]);printf ("\n" ); return 0 ;
链表:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 #include <stdio.h> #include <malloc.h> typedef int ElementType; typedef struct LNode *List;struct LNode {List MakeEmpty () ; int Length (List L) List FindKth (int K,List L) ; List Find (ElementType X,List L) ; List Insert (ElementType X,int i,List L) ; List Delete (int i,List L) ; void Print (List L) List MakeEmpty () {malloc (sizeof (struct LNode));NULL ;return L;int Length (List L) int len=0 ;while (p){ return len;List FindKth (int K,List L) {int i = 1 ; while (p && i<K){if (i == K) return p;else return NULL ;List Find (ElementType X,List L) {while (p && p->Data!=X)return p; List Insert (ElementType X,int i,List L) {if (i == 1 ){ malloc (sizeof (struct LNode));return s; FindKth (i-1 ,L); if (!p){ printf ("结点错误" );return NULL ;else {malloc (sizeof (struct LNode));return L;List Delete (int i,List L) {if (i==1 ){ if (L) else return NULL ;free (s); return L; FindKth (i-1 ,L); if (!p || !(p->Next)){ printf ("结点错误" );return NULL ;else {free (s); return L;void Print (List L) int flag = 1 ;printf ("当前链表为:" );for (t = L;t;t =t->Next){printf ("%d " ,t->Data);0 ;if (flag)printf ("NULL" );printf ("\n" ); int main () MakeEmpty ();Print (L);Insert (11 ,1 ,L);Insert (25 ,1 ,L);Insert (33 ,2 ,L);Insert (77 ,3 ,L);Print (L);printf ("当前链表长度为:%d\n" ,Length (L));printf ("此时链表中第二个结点的值是:%d\n" ,FindKth (2 ,L)->Data);printf ("查找22是否在该链表中:" );if (Find (22 ,L))printf ("是!\n" );else printf ("否!\n" );printf ("查找33是否在该链表中:" );if (Find (33 ,L))printf ("是!\n" );else printf ("否!\n" );Delete (1 ,L);Delete (3 ,L);printf ("----------删除后-----\n" ); Print (L);return 0 ;
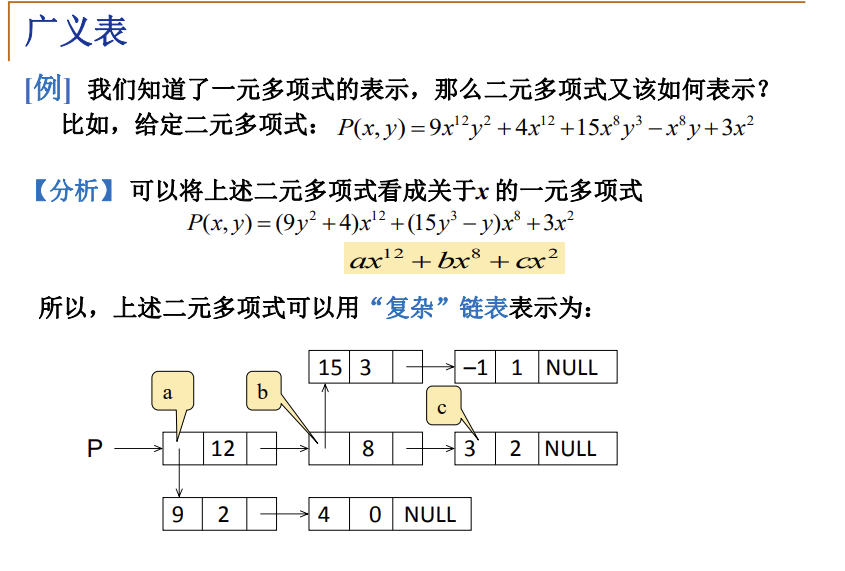
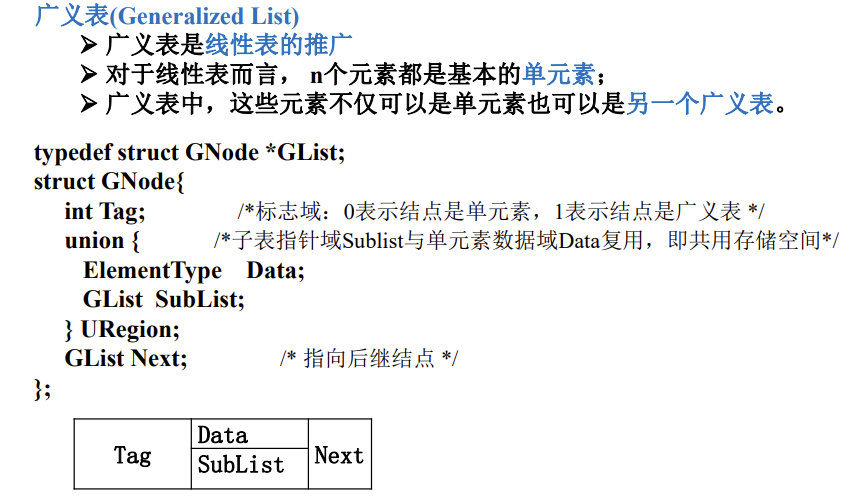
广义表
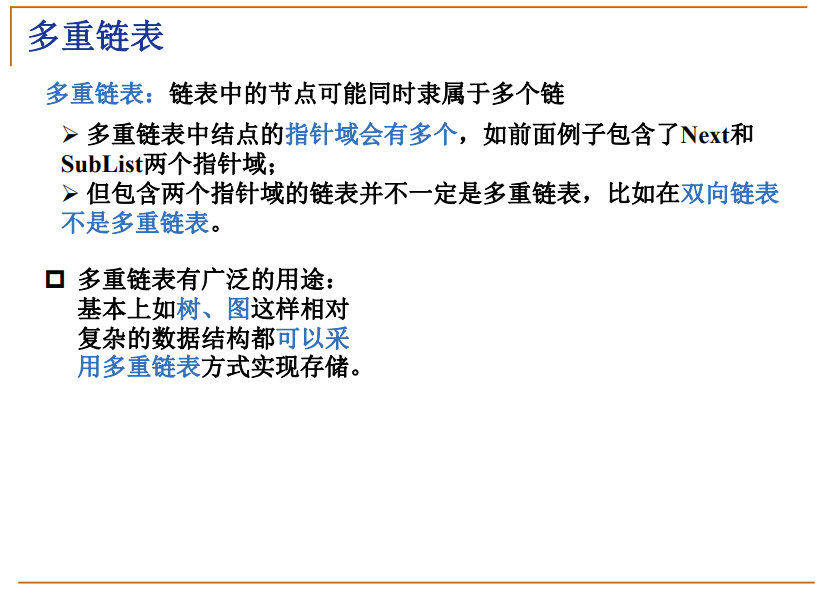
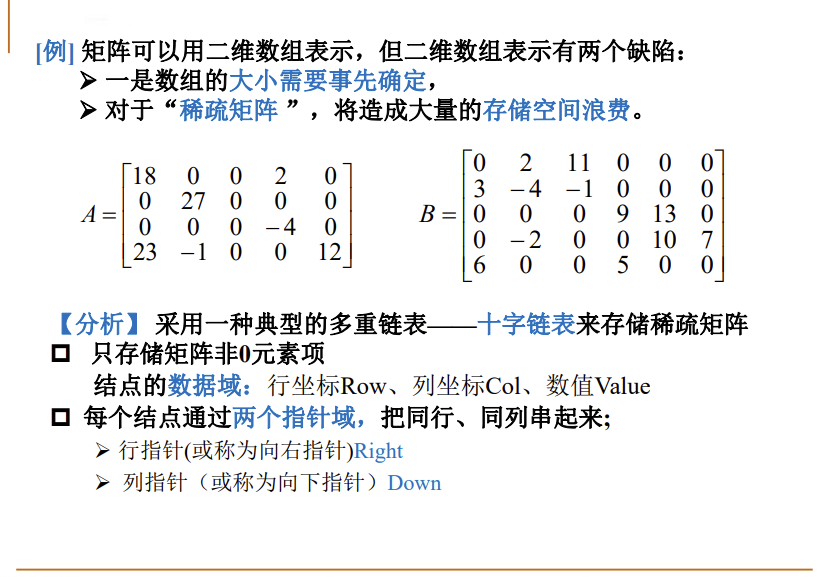
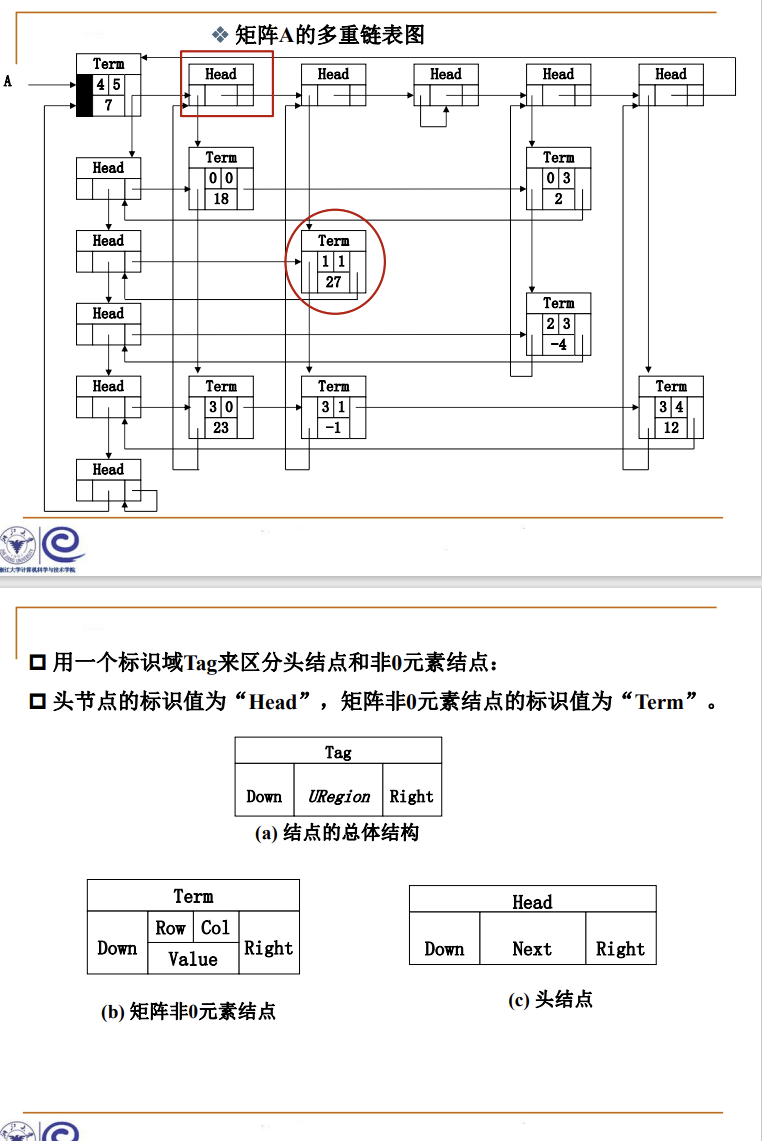
多重链表 另一个例子是链式前向星,存树用。当时就要是知道这个就好了,坡度会小很多。
栈 后进先出的数据结构,很常用
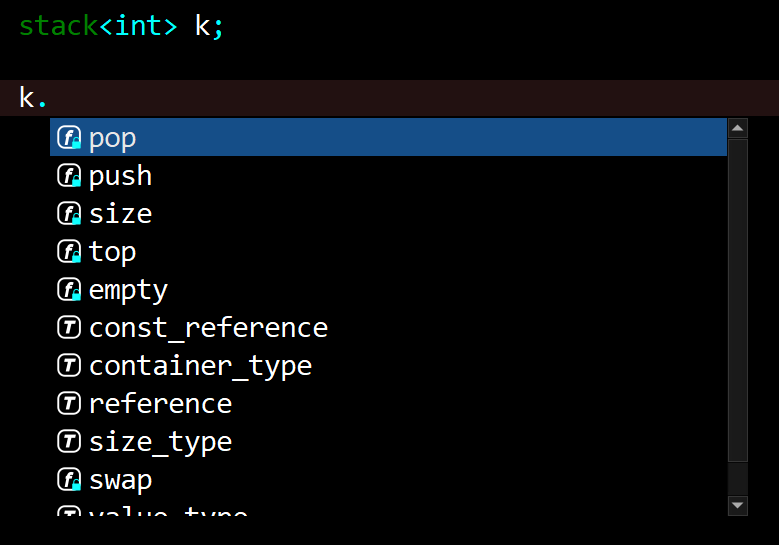
STL中的stack C++的STL提供了stack,将写好的各种功能封装,通过stack容器,可以很方便地使用栈。
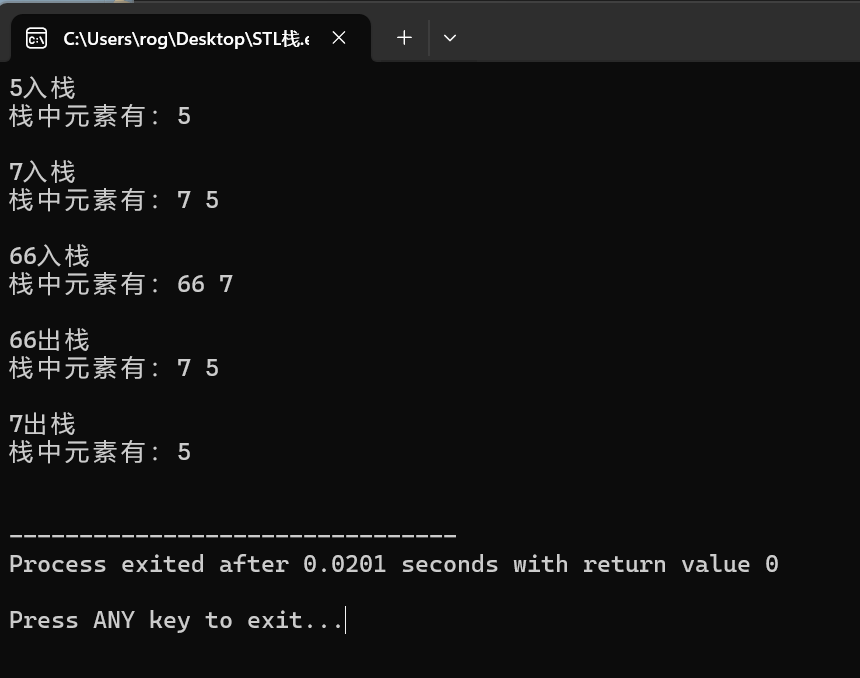
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 #include <iostream> #include <stack> using namespace std;void print (stack<int > k) int >kk = k; printf ("栈中元素有:" );for (int i = 0 ;i <= kk.size ();++ i)printf ("%d " ,kk.top ());pop ();printf ("\n" );printf ("\n" );int main () int > k;printf ("5入栈\n" );push (5 );print (k);printf ("7入栈\n" );push (7 );print (k);printf ("66入栈\n" );push (66 );print (k);printf ("%d出栈\n" ,k.top ());pop ();print (k);printf ("%d出栈\n" ,k.top ());pop ();print (k);return 0 ;
这种用法在工程中常见。因为STL写好的栈,作为C++的重要工具,经过了高度优化,综合考虑了易用性、性能、安全性、扩展性、还能够自动管理内存,是比较成熟的技术。”因此,在可能的情况下,建议使用STL std::stack。“
数组模拟的stack
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 #include <bits/stdc++.h> using namespace std;int k[10 ];int pointer = -1 ;void print () printf ("栈中元素有:" );for (int i = 0 ;i <= pointer;++ i)printf ("%d " ,k[i]);printf ("\n" );printf ("\n" );int main () printf ("5入栈\n" );5 ;print ();printf ("7入栈\n" );7 ;print ();printf ("66入栈\n" );66 ;print ();printf ("%d出栈\n" ,k[pointer]);print ();printf ("%d出栈\n" ,k[pointer]);print ();return 0 ;
这种写法在算法编程中常见,因为算法编程常常是小段程序,一般无需考虑安全性,扩展性,而是追求极致的速度。另一方面,算法编程中也不会在栈中存储太多数据,只是想用到栈这种先入后出的特性。所以,用数组模拟栈是个好办法,灵活,轻便。
栈的顺序表实现 数组实现
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 #include <stdio.h> #include <stdlib.h> #define MAXN 1000 #define maxsize 5 typedef int Elementtype;typedef struct LNode *Stack ;struct LNode {int Top;CreateStack () ;int Isempty (Stack S) ;int IsFull (Stack S) ;void Push (Stack S,Elementtype item) ;Pop (Stack S) ;void Print (Stack S) ;CreateStack () malloc (sizeof (struct LNode));-1 ;return S;void Push (Stack S,Elementtype item) if (IsFull(S)){printf ("栈满\n" );return ;int IsFull (Stack S) return (S->Top == maxsize-1 );int Isempty (Stack S) return (S->Top == -1 );Pop (Stack S) if (Isempty(S))printf ("栈空\n" );return -1 ;else {return val;void Print (Stack S) int i; printf ("栈内元素有: " );for (i = S->Top; i >= 0 ; i--) { printf ("%d " , S->Data[i]); printf ("\n" ); int main () printf ("5入栈\n" );5 );printf ("\n" );printf ("7入栈\n" );7 );printf ("\n" );printf ("66入栈\n" );66 );printf ("\n" );printf ("99入栈\n" );99 );printf ("\n" );printf ("100入栈\n" );100 );printf ("\n" );printf ("110入栈\n" );110 );printf ("\n" );printf ("%d出栈\n" ,Pop(S));printf ("\n" );printf ("%d出栈\n" ,Pop(S));printf ("\n" );printf ("%d出栈\n" ,Pop(S));printf ("\n" );printf ("%d出栈\n" ,Pop(S));printf ("\n" );printf ("%d出栈\n" ,Pop(S));printf ("\n" );printf ("%d出栈\n" ,Pop(S));printf ("\n" );printf ("%d出栈\n" ,Pop(S));printf ("\n" );return 0 ;
思考:先入后出怎么被实现的? 思考:被注释掉的那个Print()能起到同样的作用吗,哪个更好?
链表实现
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 #include <stdio.h> #include <malloc.h> typedef int ElementType;typedef struct SNode *Stack ;struct SNode {CreateStack () ; int IsEmpty (Stack S) ; void Push (Stack S,ElementType item) ; Pop (Stack S) ; CreateStack () {malloc (sizeof (struct SNode));NULL ;return S;int IsEmpty (Stack S) {return (S->Next == NULL );void Push (Stack S,ElementType item) {malloc (sizeof (struct SNode));Pop (Stack S) {if (IsEmpty(S)){printf ("堆栈空" );return ;else {free (First); return TopVal;int main () {printf ("5入栈\n" );5 );printf ("7入栈\n" );7 );printf ("66入栈\n" );66 );printf ("%d出栈\n" ,Pop(S));printf ("%d出栈\n" ,Pop(S));return 0 ;
思考:这个链表的哑结点怎么不是头指针? A: 我们知道,链表是可以调整的,让s->Next一直指向栈顶元素,即可实现先入后出
STL源码解析-stack
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
template <class T , class Sequence = deque<T> >class stack {friend bool operator == __STL_NULL_TMPL_ARGS (const stack&, const stack&);friend bool operator < __STL_NULL_TMPL_ARGS (const stack&, const stack&);public :typedef typename Sequence::value_type value_type;typedef typename Sequence::size_type size_type;typedef typename Sequence::reference reference;typedef typename Sequence::const_reference const_reference;protected :public :bool empty () const return c.empty (); }size_type size () const { return c.size (); }reference top () { return c.back (); } const_reference top () const { return c.back (); } void push (const value_type& x) push_back (x); }void pop () pop_back (); }template <class T , class Sequence >bool operator ==(const stack<T, Sequence>& x, const stack<T, Sequence>& y) {return x.c == y.c;template <class T , class Sequence >bool operator <(const stack<T, Sequence>& x, const stack<T, Sequence>& y) {return x.c < y.c;
面向对象编程,通过模板类,友元函数,运算符重载等等实现 是不是很短?为什么这点代码就能实现? 把相应的已有的容器作为底部结构,将其接口改变,使之符合stack的特性,就形成一个stack SGI STL stack默认底层容器是deque。