操作系统
操作系统学习笔记
这学期投入时间最多的课,虽然没记太多笔记,但收获很多。核心教材是《Operating Systems: Three Easy Pieces》,作者的理念是:
“Seeing how the sausage was made is nearly as important as understanding what the sausage is good for.”
教学操作系统选型
| 系统 | 年份 | 开发者 | 特点 |
|---|---|---|---|
| NachOS | 1992 | UW-Madison | 模块化设计,模拟 MIPS,简洁易懂 |
| PintOS | 2004 | MIT | 基于 x86,线程/内存/文件系统实验 |
| xv6 | 2006 | MIT | 类 Unix 简单 OS,C 语言,代码简洁 |
NachOS 选择模拟 MIPS 的原因:RISC 架构指令固定 32 位,指令集小而精简,易于教学和模拟。NachOS 并不运行在真实硬件上,而是软件模拟包括 MIPS 处理器、内存管理(分页+TLB)、I/O 设备在内的完整硬件环境。
系统调用流程(以 NachOS 为例)
1 | |
线程同步工具
三种经典工具各司其职:
- 互斥锁(Mutex):解决互斥问题——同一时刻只有一个线程访问临界区
- 条件变量(Condition Variable):解决同步问题——线程等待某个条件成立
- 信号量(Semaphore):管理共享资源的访问计数
条件变量 wait 必须做到”原子释放锁+睡眠”,否则会出现丢信号或永久睡眠的竞态问题。这是用信号量/互斥锁模拟条件变量时很难可靠的根本原因——“释放锁+等待”很难保证是不可分割的原子操作。
两类同步错误:
- Order Violation:操作顺序错误(如:信号量模拟条件变量时的原子性问题)
- Atomicity Violation:原子性被破坏(如:检查条件和改变条件之间的窗口)
进程切换、态的切换、CPU 状态切换
三者紧密相关但不同:
- 进程切换:CPU 从一个进程分配给另一个进程。通常伴随 2 次态的切换。
- 态的切换:进程状态的变换(就绪→运行→阻塞)。
- CPU 状态切换:保存和恢复寄存器、程序计数器等硬件上下文。
关系:进程切换通常伴随态的切换(2次)和 CPU 状态的切换。
推荐学习资源
- **南京大学-蒋岩炎 操作系统2025**:不再做内核实验,关注利用 OS 提供的接口解决实际问题。课程项目实用有趣,历年视频在 B 站有完整录播。强烈推荐。
- **MIT 6.S081**:实践性很强,做 xv6 内核实验。
- **CS 自学指南**:一站式自学路线。
- **PwnCollege**:计算机安全学习平台,很大程度建立在对操作系统的理解上。
- 王道考研复习指导:知识点+即时练习的模式很有效,刚出现疑惑就能在章末找到回答。
系统调用
接触教学操作系统的第一个实验可能就是在用户态实现系统调用了。
关于选择哪个教学操作系统学习,操作系统课上选择的是NachOS,罗佬推荐去学PintOS,李学长推荐去学xv6。
但是如果愿意当“烈士”,选择学长们开发的LoOS吧~
NachOS 官方文档
PintOS 官方文档
xv6 官方文档
操作系统课程资源
LoOS 项目主页
Intro
- NachOS
出现时间:1992年。
开发者:威斯康星大学麦迪逊分校的Tom Anderson教授。
特点:NachOS是一个模块化设计的教学操作系统,包含线程管理、同步机制、文件系统和内存管理等基本功能。它的代码简洁,便于学生逐步学习和扩展。
影响:NachOS在大学计算机专业的操作系统课程中被广泛使用,帮助学生理解操作系统的各种概念。 - pintos
出现时间:2004年。
开发者:麻省理工学院(MIT)。
特点:PintOS是一个基于x86架构的教学操作系统,主要用于本科操作系统的实验教学。它提供了线程管理、内存管理和文件系统等基本功能。
影响:PintOS帮助学生理解操作系统的实现细节,是MIT操作系统课程的重要组成部分 - xv6
出现时间:2006年。
开发者:麻省理工学院(MIT)。
特点:xv6是一个类似于Unix的简单操作系统,主要用于教学。它基于C语言编写,代码简洁,易于理解和扩展。
影响:xv6被广泛用于MIT的操作系统课程(如6.S081),帮助学生理解操作系统的底层实现
Background
在解释后续的系统调用实验之前,有一些操作系统的概念需要首先澄清
“Seeing how the sausage was made is nearly as important as understanding what the sausage is good for.”
系统调用的一般流程:
用户程序触发系统调用=>系统捕获系统调用的异常=>调用异常处理=>调用该系统调用的具体实现函数=>将结果返回给用户程序。
在这个 NachOS 实验中,用户程序由start.s和test.c共同组成。
以下是 NachOS 中系统调用的完整流程:
用户程序触发系统调用:
- 用户程序调用
Add函数(通过汇编封装),将系统调用号放入$2寄存器,并执行syscall指令。
- 用户程序调用
NachOS 捕获
SyscallException:在
mipssim.cc中,syscall指令触发SyscallException:1
2
3case OP_SYSCALL:
RaiseException(SyscallException, 0);
return;
调用
ExceptionHandler:在
machine.cc中,RaiseException调用ExceptionHandler:1
2
3
4
5void Machine::RaiseException(ExceptionType which, int badVAddr) {
kernel->interrupt->setStatus(SystemMode);
ExceptionHandler(which);
kernel->interrupt->setStatus(UserMode);
}
ExceptionHandler调用SysAdd:在 exception.cc 中,
ExceptionHandler根据系统调用号调用SysAdd:1
2
3
4
5
6case SC_Add:
int op1 = kernel->machine->ReadRegister(4);
int op2 = kernel->machine->ReadRegister(5);
int result = SysAdd(op1, op2);
kernel->machine->WriteRegister(2, result);
break;
SysAdd执行加法操作:SysAdd在内核模式下执行加法操作,并返回结果:1
2
3int SysAdd(int op1, int op2) {
return op1 + op2;
}
返回结果给用户程序:
ExceptionHandler将结果写回$2寄存器,用户程序从$2寄存器中读取结果。
双模态:
我们希望让程序更快运行,很容易想到就是让程序直接运行在CPU上,但是,程序还可能进行IO操作和其它有访问限制的操作,这又要求我们不能给以程序对系统的完全控制。
如果程序任意执行它的在I/O和相关操作,那么对于一些系统的保护就会失效,(程序可以对全盘进行读取,这是不期望的设计)。
因此,就引入了双模态——用户态和内核态:
必须区分操作系统代码和用户代码的执行。大多数计算机系统采用硬件支持,以便区分各种执行模式。
大多数现代操作系统,Windows 7,UNIX,Linux,都利用了双模态的特点,为操作系统提供了更强的保护。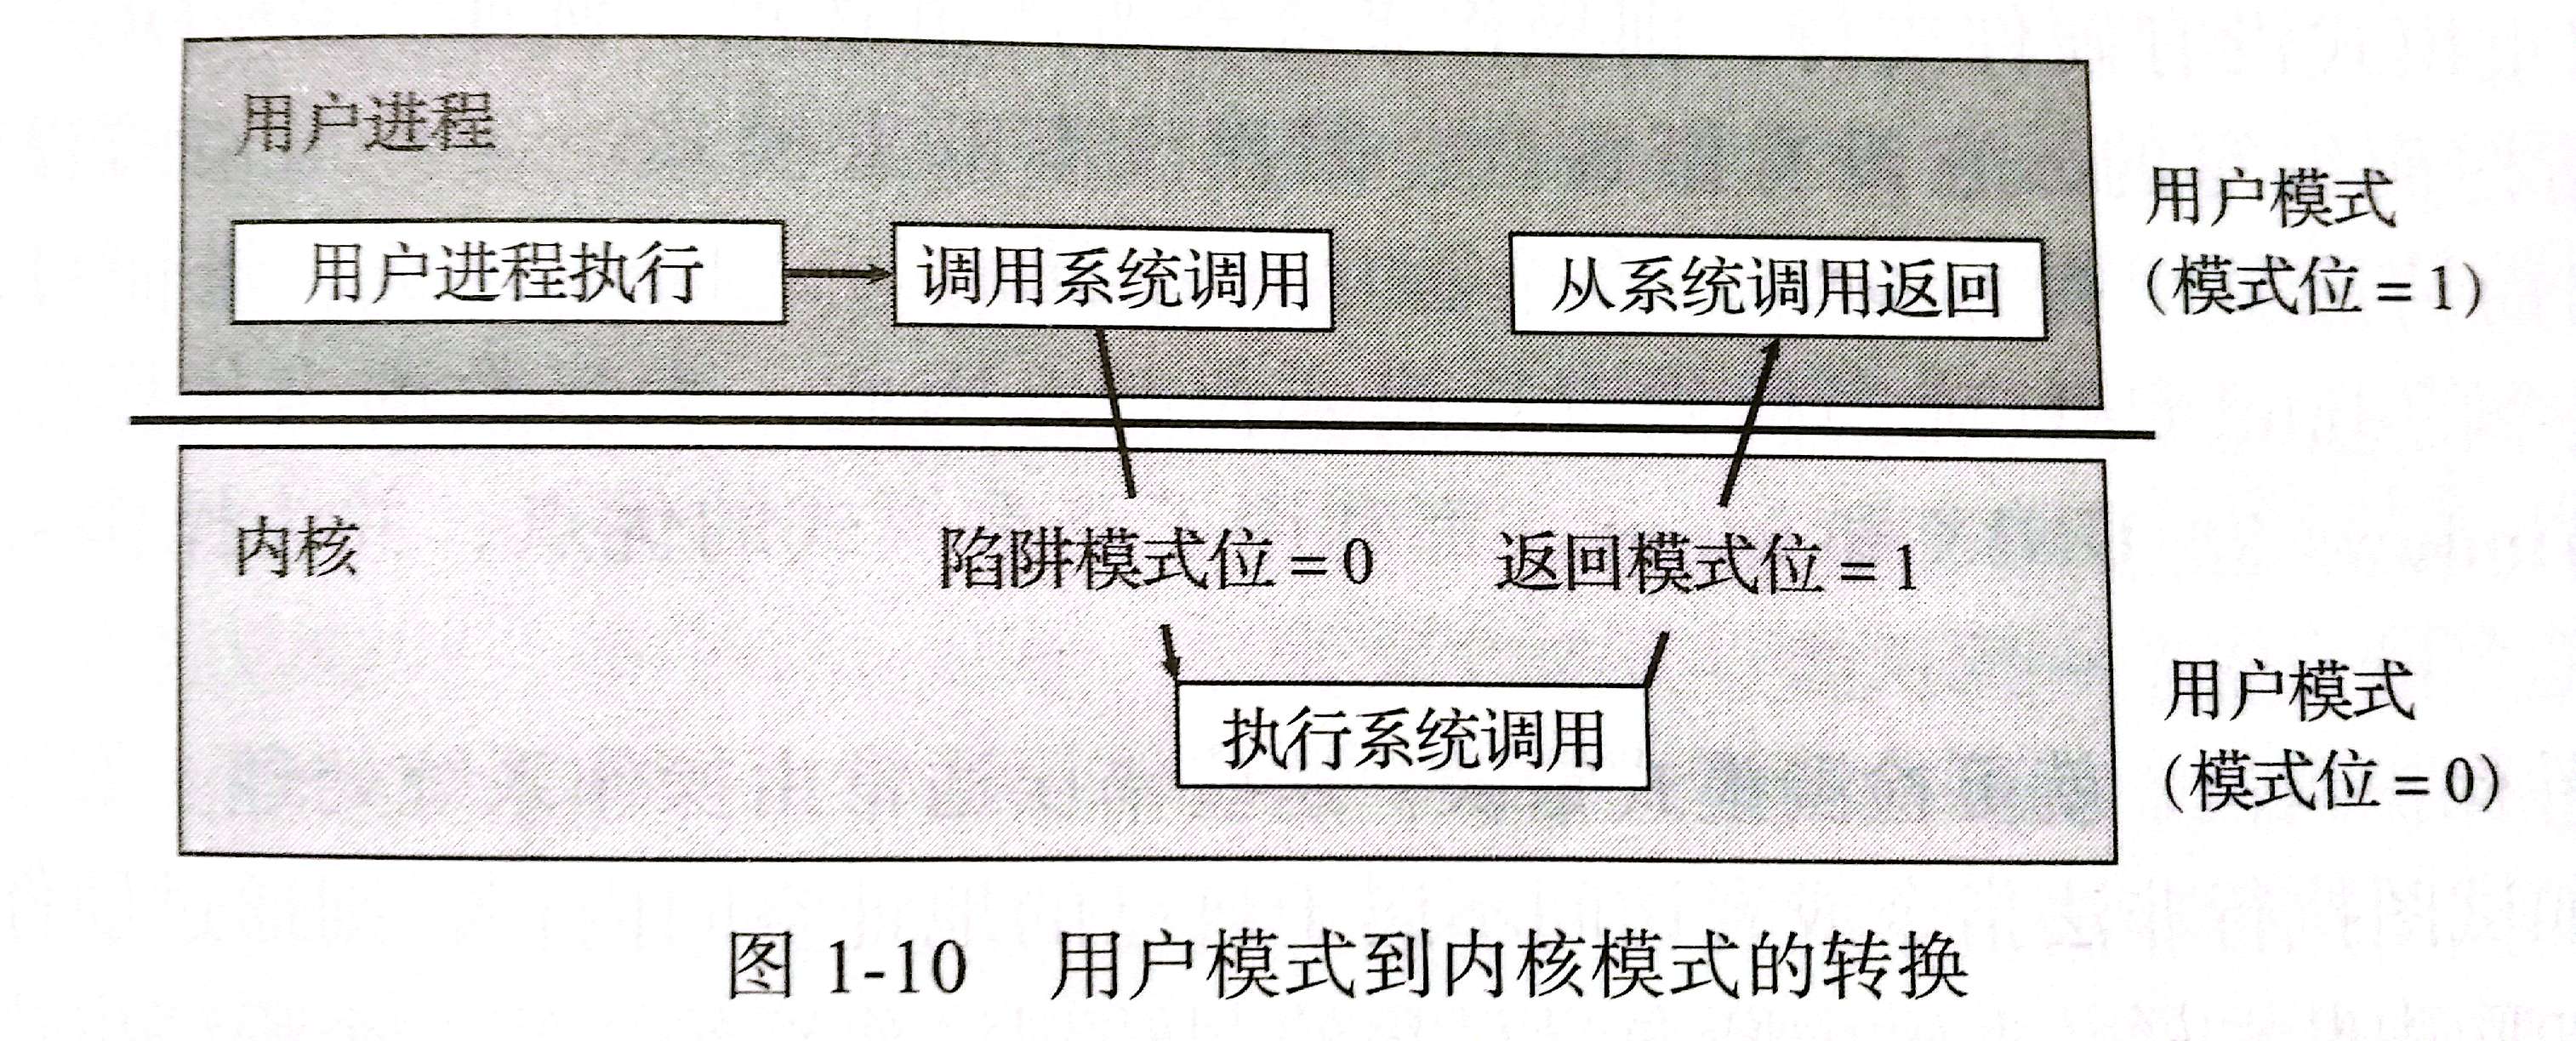
双模态提供保护手段,以便防止操作系统和用户程序收到错误的用户程序的影响。
这种保护的实现:将可能引起损害的机器指令作为特权指令,并且硬件只有在内核模式下才允许执行特权指令。
链接
本实验有一个易错点就是,要理解链接是对.c文件进行的,它们的函数名都要保持一致(理解链接的作用)
程序的链接是将多个目标文件和库文件组合成一个可执行文件的过程。链接的主要目的是将程序的各个部分(如函数和变量)正确地连接起来,以便程序可以运行。
链接器的作用
链接器是完成链接过程的工具,常见的链接器包括 GNU 的 ld 和 Microsoft 的 link。它们的主要任务是:
- 合并多个目标文件。
- 解析符号并处理依赖关系。
- 生成最终的可执行文件或库文件。
通过链接,程序的各个部分得以整合,形成一个完整的、可以运行的应用程序。
汇编
可以注意到我们NachOS的实验中使用了汇编代码,那么这里为什么非要用汇编,汇编代码的作用是什么?
现代操作系统(如 Ubuntu 的 Linux 内核)中,系统调用仍然需要底层汇编的支持,但用户程序通常不直接使用汇编来触发系统调用。这是因为现代编程环境提供了更高层次的抽象(如 C 标准库),隐藏了底层的汇编细节。以下是原因和机制:
1. 系统调用仍然依赖汇编
- 系统调用的本质:
系统调用是用户程序进入内核模式的唯一途径,通常通过触发特定的 CPU 指令(如 syscall 或 int 0x80)实现。
这些指令是硬件支持的,必须用汇编语言触发。
- 汇编的必要性:
即使使用 C 语言调用系统调用,底层仍然需要汇编代码来完成寄存器设置和触发系统调用指令。
2. 为什么用户程序不直接使用汇编
- C 标准库的封装:
在 Linux 系统中,C 标准库(如 glibc)为系统调用提供了封装。例如,调用 write() 函数时,glibc 会在内部使用汇编触发系统调用。
用户程序只需调用高层次的 C 函数,而不需要关心底层实现。 - 可移植性:
如果用户程序直接使用汇编代码,程序将与特定的硬件架构绑定(如 x86 或 ARM)。
使用 C 标准库封装后,程序可以在不同架构上运行,而无需修改代码。 - 简化开发:
汇编代码难以维护和调试。通过使用 C 语言和标准库,开发者可以专注于业务逻辑,而不必处理底层细节。
为什么 NachOS 需要显式汇编
NachOS 是一个教学操作系统,目的是帮助学生理解操作系统的底层机制。
在 NachOS 中,start.s 明确展示了系统调用的触发过程(如将系统调用编号放入寄存器并执行 syscall 指令),以便学生学习和实验。
NachOS 没有像 Linux 那样的标准库封装,因此需要显式使用汇编代码。
start.s 文件在 NachOS 中的主要作用是为用户程序提供启动代码和系统调用的汇编封装。虽然理论上可以用 C 语言代替部分功能,但由于 NachOS 的架构和底层实现,start.s 的存在是必要的,原因如下:
1. 系统调用的实现依赖于汇编
- 系统调用需要触发
syscall指令:- 在 NachOS 中,用户程序通过触发
syscall指令进入内核模式,而syscall是一个汇编指令,无法直接用 C 语言实现。 start.s中的封装函数(如Add、Halt等)将系统调用编号和参数放入寄存器,然后触发syscall指令。这种底层操作必须用汇编实现。
- 在 NachOS 中,用户程序通过触发
2. 用户程序的启动代码
- 初始化用户程序的入口点:
- NachOS 的用户程序需要一个固定的入口点(
__start),这是内核加载用户程序后跳转的第一条指令。 start.s定义了这个入口点,并调用用户程序的main函数。- 如果用 C 语言实现,仍然需要依赖汇编代码来设置入口点和初始化寄存器。
- NachOS 的用户程序需要一个固定的入口点(
3. C 语言的局限性
C 语言无法直接操作寄存器:
- NachOS 的系统调用机制依赖于将系统调用编号和参数放入特定的寄存器(如
$2、$4、$5等),然后触发syscall指令。 - C 语言无法直接操作这些寄存器,因此必须使用汇编代码。
- NachOS 的系统调用机制依赖于将系统调用编号和参数放入特定的寄存器(如
C 语言无法定义全局入口点:
- 在 NachOS 的架构中,用户程序的入口点是由
start.s定义的。如果完全用 C 语言实现,无法直接定义全局的_start或__start符号。
- 在 NachOS 的架构中,用户程序的入口点是由
4. 替代方案的复杂性
- 混合使用 C 和内联汇编:
- 理论上,可以用 C 语言结合内联汇编来实现
start.s的功能,但这会增加代码的复杂性,并且可能导致平台相关的问题。 - 例如,以下是一个用 C 和内联汇编实现的系统调用封装:这种实现虽然可行,但代码可读性差,且依赖于特定的汇编语法。
1
2
3
4
5
6
7
8
9
10
11
12
13
14int Add(int op1, int op2) {
int result;
asm volatile (
"li $2, 42\n" // SC_Add
"move $4, %1\n"
"move $5, %2\n"
"syscall\n"
"move %0, $2\n"
: "=r" (result)
: "r" (op1), "r" (op2)
: "$2", "$4", "$5"
);
return result;
}
- 理论上,可以用 C 语言结合内联汇编来实现
5. NachOS 的设计哲学
- NachOS 的设计目的是教学,
start.s的存在可以帮助学生理解用户程序与内核之间的交互机制。 - 使用汇编代码明确展示了系统调用的底层实现,有助于学习操作系统的基本原理。
总结
start.s 是 NachOS 中不可或缺的一部分,因为它:
- 提供了用户程序的启动代码。
- 实现了系统调用的汇编封装。
- 直接操作寄存器和触发
syscall指令,这是 C 语言无法完成的。
虽然可以用 C 语言结合内联汇编部分替代 start.s 的功能,但这会增加代码复杂性,且违背 NachOS 的教学目的。因此,start.s 是必要的,且是实现 NachOS 系统调用机制的最佳方式。
NachOS实验-实现系统调用
实验:模仿add()的实现,通过系统调用实现Multiply(),Divide(),Power(),Sub()这四种操作。
目的:
- 在Linux系统中,用户进程如何运行?
- 用户进程与系统如何交互?
- 系统调用是如何实现的?
查看用户test目录下Makefile
1 | |
.c文件被先编译成.o文件,再链接(“LD”)成.coff文件,再经处理形成.noff文件——NetBSD Object File Format
1 | |
所有的用户程序都要跟start.o文件进行链接
而start.o文件依赖于start.s和syscall.h
这个实验共需关注五个文件:
test.c,start.s,syscall.h,ksyscal.h,exception.cc
查看start.s
可以看出start.s定义了用户程序的入口,这些实现的指令就是操作系统提供给用户的接口函数API。
eg:
1 | |
1 | |
在MIPS体系结构中,$0中永远存着0,addiu是无符号数相加
eg:将系统调用号SC_Add放到$2寄存器中
执行系统调用syscall
j指令进行无条件跳转,跳转到$31中执行
这些指令的更具体实现在/nachos-4.1/code/machine/mipssim.cc中:
从中可以看出系统调用被处理的全过程:
这里的SyscalException由刚刚start.s的syscall触发:
1 | |
可以看到像OP_SYSCALL这样的指令就属于特权指令,抛出一个异常: RaiseException(SyscallException, 0);
CRTL单击”RaiseException()”来到machine.cc:
定义在machine.h中
1 | |
1 | |
NachOS 的双模态(用户模式和内核模式)切换是通过 InterruptStatus 来管理。
- 模式切换发生在
RaiseException内部:1
2
3kernel->interrupt->setStatus(SystemMode);
ExceptionHandler(which);//!!!实际系统调用的实现
kernel->interrupt->setStatus(UserMode);SystemMode表示进入内核模式。UserMode表示返回用户模式。
F12转到定义进入ExceptionHandler()的具体实现——exception.cc
查看并修改exception.cc
这里的第一句”int type = kernel->machine->ReadRegister(2);”
就是读取二号寄存器,回想start.s里边,系统调用号被存到了$2中,这里的type就会是系统调用号:
之后通过switch语句,对要求的系统调用SyscallException的操作分别处理。
1 | |
这里就需要模仿SC_Add,添加SC_Multiply,SC_Divide……的系统调用实现。
1 | |
这里的DEBUG增添了调试信息,方便之后运行时测试。
注意这里就是在内核态运行的程序,是NachOS对系统调用的具体实现:
以SysAdd()为例,4号和5号寄存器中的值被传入SysAdd()函数进行相加
结果返回后被存入2号寄存器($2)
这里是操作系统对程序计数器的管理:
在 MIPS 架构中,程序计数器(PC)用于指向当前正在执行的指令的地址。为了正确执行程序,NachOS 需要维护以下三个寄存器:
- PrevPCReg: 保存上一条指令的地址(用于调试)。
- PCReg: 保存当前正在执行的指令的地址。
- NextPCReg: 保存下一条指令的地址(用于分支预测和流水线执行)。
1
2
3
4
5
6
7
8
9
10{
/* set previous programm counter (debugging only)*/
kernel->machine->WriteRegister(PrevPCReg, kernel->machine->ReadRegister(PCReg));
/* set programm counter to next instruction (all Instructions are 4 byte wide)*/
kernel->machine->WriteRegister(PCReg, kernel->machine->ReadRegister(PCReg) + 4);
/* set next programm counter for brach execution */
kernel->machine->WriteRegister(NextPCReg, kernel->machine->ReadRegister(PCReg)+4);
}
到现在为止,已经完成了系统调用的实现:
但是刚刚还忽略了两个问题:
- Q1.exception.cc中为什么不可以直接+-*/实现,还需要调用SysAdd()函数去执行?
SysAdd()被定义和实现在哪里? - Q2.exception.cc中
type变量取到了系统调用号,但它是怎么对应到SC_Add这样的系统调用类型的?
查看并修改ksyscall.h
定义了系统调用在内核中的具体实现(如 SysAdd、SysMultiply 等)
A1:/userprog/ksyscall.h,可以看到这个文件已经不在位于内核的目录下,但却规定了在内核态要被执行的代码。
/userprog 目录是 NachOS 中用户程序支持模块的核心部分,负责用户程序的加载、执行、系统调用处理和异常处理。它是用户程序与内核交互的桥梁,体现了操作系统如何管理和支持用户程序的运行。
这就是为用户程序开的那扇门,灵活地定制了特殊的内核态执行逻辑。
- 这些函数直接操作 NachOS 的内核对象(如
kernel->interrupt->Halt()),而这些对象只能在内核态访问。 - 如果这些函数在用户态执行,用户程序将无法直接访问内核资源。
实验中所实现的加减乘除实际上不是会对内核造成威胁的操作,也不涉及操作内核对象,所以说:
实际上可以在exception.cc中直接对+-*/进行实现,单独写到ksyscall.h中是为了教学所需,展现一个标准的系统调用过程。
查看并修改syscall.h
这是内核为系统调用提供的接口
A2:可以看到这里是在syscall.h中通过宏定义的方式实现的:
1 | |
宏定义的特点是简单、灵活、无类型、无作用域限制。也就是说,在全局(所有文件)中,SC_Add就对应42……
/test目录创建test.c进行验证
总结:
在成熟的Linux操作系统中,glibc帮我们实现了这一系列复杂的过程,只需要导入相关的库文件就可以开发用户程序。
在教学操作系统NachOS中,我们开始自己动手去实现这样的库文件,将这些实现展开成start.s、test.c、ksyscall.h……这,NachOS给我们提供了关注系统调用的具体实现过程的机会。
整个实验的通过start.s和test.c的执行线索展开,逐步进入操作系统的内部,亲历实现的全过程
实验中一共修改过5份代码,分成三组:
用户程序:
test.c 用户程序
start.s 用户程序的启动代码内核程序:
exception.cc
(mipssim.cc) 异常处理=>系统调用
(machine.cc) 中断与恢复
(machine.h) 定义不同的异常捕获与处理桥梁:
ksyscall.h 系统调用在内核中的具体实现
syscall.h 内核为系统调用提供的接口
整个过程可以当作是两组程序的交互过程…,类似一组前后端程序的联调,系统中通过参数传递与函数调用的方式完成这个过程。
Ps
除此之外还有一些值得关注的点:
例如,我们在《计算机组成原理》中刚刚学过的 MIPS架构——无互锁流水线阶段的微处理器
NachOS包含一个MIPS指令集的模拟器,用于模拟MIPS架构的处理器。
RISC与MIPS与NachOS
“CPU的MIPS系列是目前最成功和最灵活的设计之一”
“MIPS架构是RISC指令集架构设计思想的一种具体实现”
“采用小端存储方式、按字寻址、三地址结构、定长ISA。它是一个取-存架构,即只有装载和存储指令才能够访问存储器。所有的其他指令必须使用寄存器来存储操作数, 这就意味着这一指令集架构需要大量的寄存器集合。”
“MIPS有一个明确的指令集,这包括五种基本的指令类型:简单的算术指令(add,XOR,NAND,shift)、数据传送指令(load、store、move)、控制指令(branch、jump)、多周期指令(multiply、divide)、和其它指令(load、store、move)”
“MIPS程序员可以使用立即寻址,寄存器寻址,直接寻址,寄存器间接寻址,基址寻址和变址寻址等方式,然而ISA只能提供一种寻址方式(基址寻址),其余的寻址方式是由编译器提供的,”
在NachOS中MIPS的这些特点被很好地印证了:
小端存储方式
例如在exception.cc中作者给出的注释:
// The only difference between this code and the BIG ENDIAN code
// is that the ReadMem call is guaranteed an aligned access as it
// should be (Kane’s book hides the fact that all memory access
// are done using aligned loads - what the instruction asks for
// is a arbitrary) This is the whole purpose of LWL and LWR etc.
// Then the switch uses 3 - (tmp & 0x3) instead of (tmp & 0x3)
// 这段代码与大端(BIG ENDIAN)代码的唯一区别在于,
// ReadMem 调用保证了对齐访问,正如它应该做到的那样(Kane 的书掩盖了所有内存访问
// 都是通过对齐加载完成的事实——指令所要求的是任意的访问)。
// 这也是 LWL(Load Word Left) 和 LWR 等指令的全部目的所在。
// 然后,switch 使用的是 3 - (tmp & 0x3),而不是 (tmp & 0x3)。
又例如:
- 代码位置: translate.cc, machine.cc
- 代码示例:
1 | |
- 解释:
WordToHost和ShortToHost函数用于在小端和大端存储之间进行转换。NachOS 默认假设主机是小端存储,因此这些函数通常是 NOP 操作。
按字寻址**
- 代码位置: mipssim.cc
- 代码示例:
1 | |
- 解释: NachOS 的
ReadMem函数以 4 字节(一个字)的单位读取内存。MIPS 指令长度固定为 4 字节,因此按字寻址。
定长 ISA**
- 代码位置: mipssim.cc
- 代码示例:
1 | |
- 解释: MIPS 指令长度固定为 32 位(4 字节)。
Decode函数通过位操作解析指令的各个字段。
又如,刚刚实验中的代码片段:
1 | |
对PC寄存器进行处理时,指向下一条指令地址是+4操作:4*8=32,这也说明了其MIPS 指令长度固定为 32 位。
取-存架构
- 代码位置: mipssim.cc
- 代码示例:
1 | |
- 解释:
LW和SW指令分别用于从内存加载数据到寄存器和将寄存器数据存储到内存。其他指令只能操作寄存器。
三地址结构
这是我们实验中mipsim.cc(MIPS模拟器)对MIPS架构所规定的简单的算术指令的实现:case OP_ADDIU 是 start.s 中 addiu 指令的底层实现。它模拟了 MIPS 架构中 addiu 指令的行为,将源寄存器的值与立即数相加,并将结果存储到目标寄存器中。
这个addiu就是我们在start.s调用的那条汇编指令!它的底层实现通过如下的三地址结构:
- 代码位置: mipssim.cc
- 代码示例:
1 | |
- 解释: MIPS 使用三地址结构,
rd是目标寄存器,rs和rt是源寄存器。上述代码实现了ADD指令。
算术指令
- 代码位置: mipssim.cc
- 代码示例:
1 | |
- 解释: 算术指令如
SUB和XOR操作寄存器中的数据,并将结果存储到目标寄存器。
数据传送指令
- 代码位置: mipssim.cc
- 代码示例:
1 | |
- 解释: 数据传送指令如
LW和SW用于在内存和寄存器之间传递数据。
控制指令
- 代码位置: mipssim.cc
- 代码示例:
1 | |
- 解释: 控制指令如
BEQ和J用于条件分支和跳转。
** 多周期指令**
- 代码位置: mipssim.cc
- 代码示例:
1 | |
- 解释: 多周期指令如
MULT和DIV需要多个时钟周期完成操作,结果存储在HiReg和LoReg。
在 NachOS 中,MIPS 的寻址方式(如直接寻址、寄存器间接寻址)由编译器生成的指令和 NachOS 的指令模拟器(mipssim.cc)共同实现。以下是不同寻址方式的代码位置和实现细节:
1. 基址寻址(Base Addressing)
- 代码位置:
mipssim.cc - 代码示例:
1 | |
- 解释:
- 基址寻址是 MIPS 的主要寻址方式。
instr->rs是基址寄存器,instr->extra是偏移量。- 例如,
LW $t0, 4($t1)将$t1 + 4的内存内容加载到$t0。
2. 立即寻址(Immediate Addressing)
- 代码位置:
mipssim.cc - 代码示例:
1 | |
- 解释:
- 立即寻址使用指令中的立即数作为操作数。
- 例如,
ADDI $t0, $t1, 10将$t1 + 10的结果存储到$t0。
3. 寄存器间接寻址(Register Indirect Addressing)
- 代码位置:
mipssim.cc - 代码示例:
1 | |
- 解释:
- 寄存器间接寻址使用寄存器中的值作为目标地址。
- 例如,
JR $t1将程序跳转到$t1中存储的地址。
4. 直接寻址(Direct Addressing)
- 代码位置:
mipssim.cc - 代码示例:
1 | |
- 解释:
- 直接寻址使用指令中的目标地址作为跳转目标。
- 例如,
J 0x00400000将程序跳转到地址0x00400000。
5. 编译器模拟的寻址方式
MIPS 的其他寻址方式(如变址寻址、寄存器间接寻址)通常由编译器通过生成特定的指令序列来模拟。例如:
变址寻址:
编译器会生成一条
ADD指令计算目标地址,然后使用LW或SW访问内存。示例:
1
2ADD $t0, $t1, $t2 # 计算目标地址
LW $t3, 0($t0) # 加载内存内容
寄存器间接寻址:
编译器会直接使用寄存器中的值作为地址。
示例:
1
JR $t1 # 跳转到寄存器 $t1 中存储的地址
6. NachOS 的实现机制
NachOS 的 Instruction::Decode 函数负责解析指令的字段(如 rs、rt、extra),并将其传递给 Machine::OneInstruction 执行。以下是指令解码的代码:
- 代码位置:
mipssim.cc - 代码示例:
1 | |
- 解释:
Decode函数解析指令的操作码和操作数。- 不同的寻址方式通过
extra(立即数或偏移量)和寄存器字段(rs、rt)实现。
总结
NachOS 中的寻址方式主要由 mipssim.cc 中的指令模拟器实现,具体包括:
- 基址寻址: 使用
LW和SW指令。 - 立即寻址: 使用
ADDI和ORI指令。 - 寄存器间接寻址: 使用
JR指令。 - 直接寻址: 使用
J和JAL指令。
其他复杂的寻址方式(如变址寻址)通常由编译器通过指令序列模拟实现,而 NachOS 的指令模拟器负责执行这些指令。
LoOS实验-实现系统调用
可以类比NachOS的过程,大同小异,因为LoOS使用qemu模拟器模拟硬件环境,所以看起来会简单一些。
1. 理解系统调用机制
- 阅读目标架构(如 LoongArch)的 ISA 文档,了解系统调用的实现方式。
- 系统调用通常通过特定的指令(如
scall或syscall)触发,使用寄存器传递参数和返回值。
2. 在内核中实现系统调用
步骤:
定义系统调用函数:
在内核代码中实现系统调用的逻辑。例如,在 syscall.c 中实现
sys_getppid:1
2
3uint64_t sys_getppid(void) {
return current->parent->pid; // 返回父进程的 PID
}
注册系统调用:
在系统调用表(如
syscall.tbl或syscall.c)中注册系统调用号和对应的函数:1
syscall_table[173] = (void *)sys_getppid; // 173 是 sys_getppid 的系统调用号
编译内核:
- 重新编译内核以包含新的系统调用实现。
3. 编写用户态测试程序
步骤:
编写汇编代码:
在用户态编写汇编代码,通过系统调用号触发内核中的系统调用。例如,在 sys_test.s 中:
1
2
3
4
5
6
7
8
9.section .text
.global _start
_start:
li a7, 173 # 系统调用号 SYS_GETPPID
scall # 触发系统调用
li a7, 93 # 系统调用号 SYS_EXIT
li a0, 0 # 退出状态码
scall
编译汇编代码:
使用工具链将汇编代码编译为目标文件:
1
loongarch64-linux-gnu-as -o /tmp/sys_test.o scripts/gradelib/sys_test.s
链接生成可执行文件:
使用链接器生成静态可执行文件:
1
loongarch64-linux-gnu-ld -static -o /tmp/sys_test /tmp/sys_test.o
运行测试程序:
将生成的可执行文件复制到目标环境(如 QEMU 模拟器)并运行:
1
./sys_test
4. 验证系统调用
步骤:
- 检查返回值:
- 验证系统调用是否返回正确的结果(如父进程的 PID)。
- 调试和修复:
- 如果系统调用未按预期工作,检查内核实现、系统调用号、参数传递等。
运行自动化测试:
使用脚本(如 grade-lab1-sys)验证系统调用的功能:
1
2chmod +x scripts/gradelib/grade-lab1-sys
./scripts/gradelib/grade-lab1-sys
5. 总结
- 内核部分:
- 实现系统调用逻辑。
- 注册系统调用号。
- 重新编译内核。
- 用户态部分:
- 编写汇编代码触发系统调用。
- 编译和链接生成可执行文件。
- 运行测试程序验证功能。
NachOS 环境与MIPS模拟
NachOS环境安装与简介笔记。
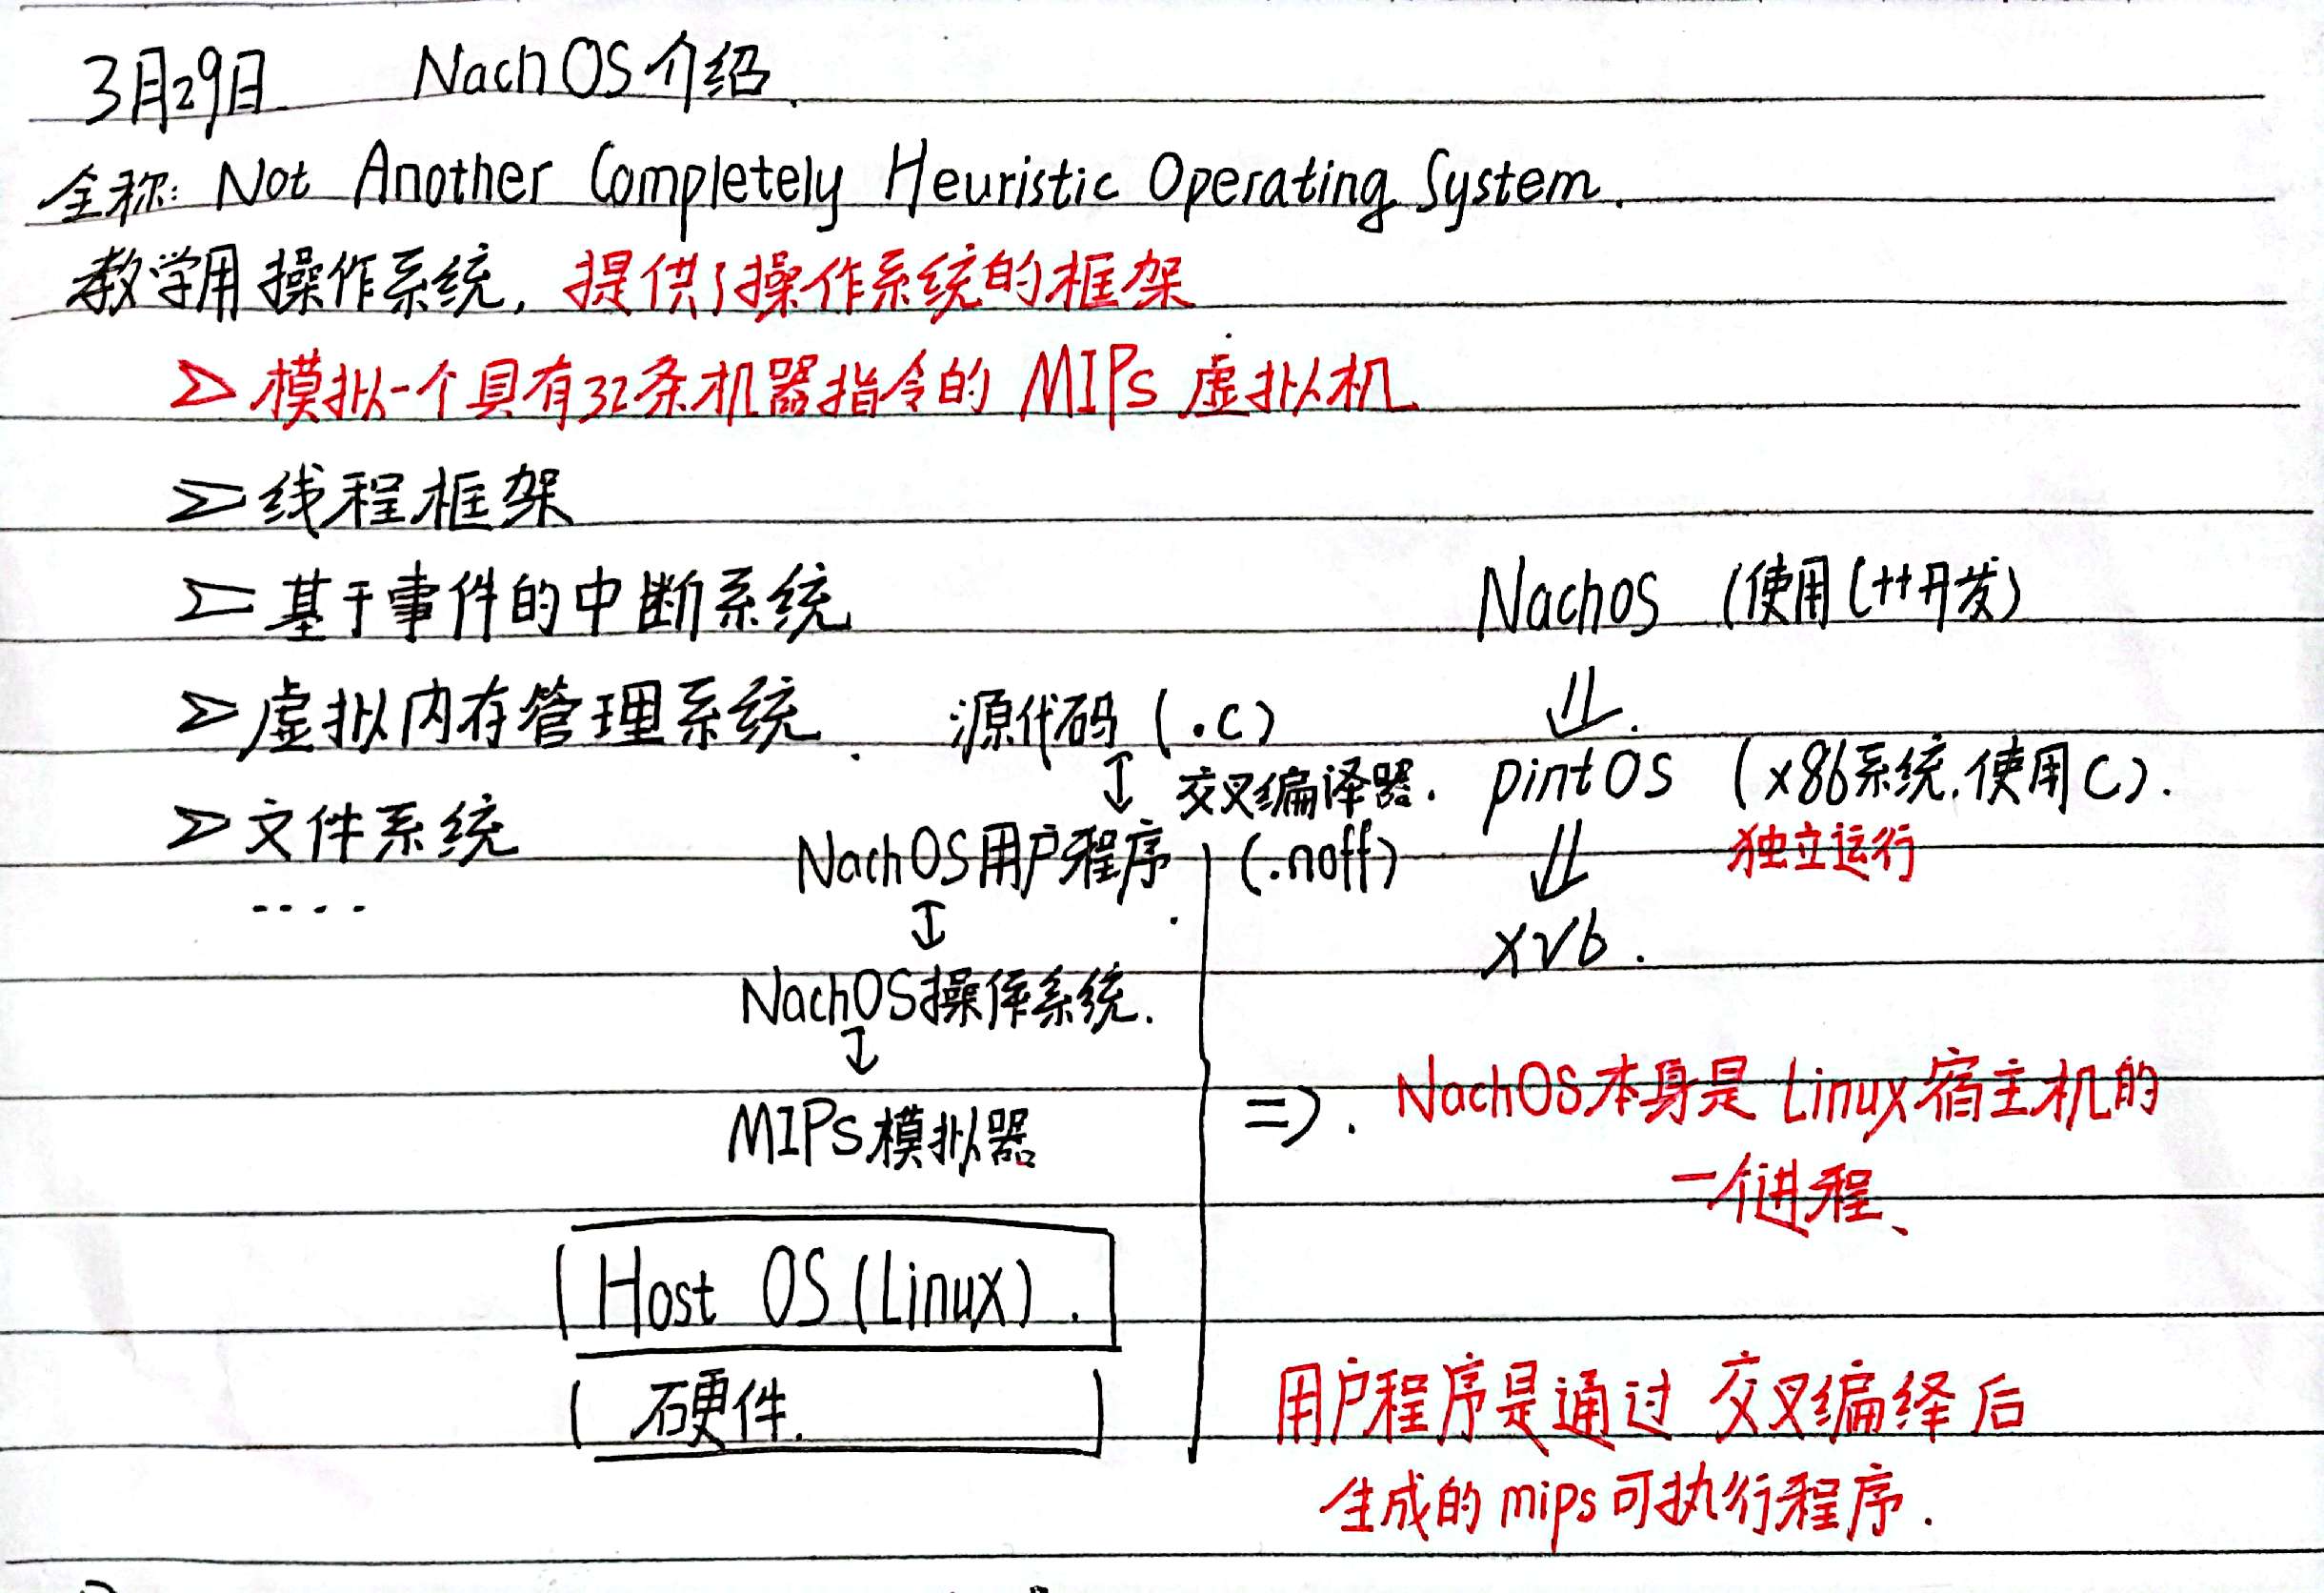
1. NachOS 的硬件环境
NachOS 并不运行在真实的硬件上,而是通过软件模拟一个简化的硬件环境,包括:
MIPS R2000/R3000 处理器:
- 模拟了 MIPS 的指令集(如算术指令、逻辑指令、分支指令、加载/存储指令等)。
- 模拟了 MIPS 的寄存器(如
$0、$2、PC等)。 - 模拟了 MIPS 的异常处理机制(如
SyscallException、OverflowException等)。
内存管理:
- NachOS 模拟了物理内存和虚拟内存的地址转换。
- 支持分页机制和 TLB(Translation Lookaside Buffer)。
I/O 设备:
- 模拟了简单的控制台输入输出。
- 提供了磁盘和文件系统的模拟。
2. 为什么选择模拟 MIPS
NachOS 选择模拟 MIPS 的原因主要包括以下几点:
(1) MIPS 的简洁性
固定指令长度:
MIPS 的指令长度固定为 32 位,指令格式简单,易于解析和模拟。
NachOS 的指令解码逻辑(如
Instruction::Decode)非常简洁:1
2
3
4rs = (value >> 21) & 0x1f;
rt = (value >> 16) & 0x1f;
rd = (value >> 11) & 0x1f;
extra = value & 0xffff;
RISC 架构:
- MIPS 是一种 RISC(精简指令集计算机)架构,指令集小而精简,便于教学和模拟。
- NachOS 的设计目标是教学,因此选择了易于理解的 MIPS 架构。
(2) 教学目的
- NachOS 是一个教学操作系统,旨在帮助学生理解操作系统的基本原理。
- MIPS 是许多计算机体系结构课程中常用的教学架构,学生对其指令集和行为较为熟悉。
- 模拟 MIPS 可以让学生专注于操作系统的设计,而无需处理复杂的硬件细节。
(3) MIPS 的广泛应用
- 在 NachOS 开发时(20 世纪 90 年代),MIPS 是一种流行的嵌入式处理器架构,广泛应用于路由器、游戏机等设备。
- 模拟 MIPS 可以让学生了解一种实际使用的处理器架构。
(4) NachOS 的历史背景
NachOS 的开发者选择 MIPS 是因为当时的 MIPS 模拟器(如 Ousterhout 的 MIPSSIM)已经存在,NachOS 可以直接基于这些模拟器进行开发。
NachOS 的 mipssim.cc 文件中明确提到:
1
2// mipssim.cc -- simulate a MIPS R2/3000 processor
// This code has been adapted from Ousterhout's MIPSSIM package.
3. NachOS 如何模拟 MIPS
NachOS 的 MIPS 模拟器主要由以下部分组成:
(1) 指令解码
NachOS 使用
Instruction::Decode函数解析 MIPS 指令的字段(如操作码、寄存器编号、立即数等)。示例代码:
1
2
3
4
5
6void Instruction::Decode() {
rs = (value >> 21) & 0x1f; // 源寄存器
rt = (value >> 16) & 0x1f; // 目标寄存器
rd = (value >> 11) & 0x1f; // 结果寄存器
extra = value & 0xffff; // 偏移量或立即数
}
(2) 指令执行
NachOS 使用
Machine::OneInstruction函数模拟 MIPS 指令的执行。示例代码:
1
2
3
4
5
6
7
8
9case OP_ADD:
sum = registers[instr->rs] + registers[instr->rt];
if (!((registers[instr->rs] ^ registers[instr->rt]) & SIGN_BIT) &&
((registers[instr->rs] ^ sum) & SIGN_BIT)) {
RaiseException(OverflowException, 0);
return;
}
registers[instr->rd] = sum;
break;
(3) 异常处理
NachOS 模拟了 MIPS 的异常处理机制,例如系统调用异常(
SyscallException)和算术溢出异常(OverflowException)。示例代码:
1
2
3case OP_SYSCALL:
RaiseException(SyscallException, 0);
return;
(4) 内存管理
NachOS 模拟了 MIPS 的地址转换机制,包括页表和 TLB。
示例代码:
1
2
3
4
5
6
7int Machine::Translate(int virtAddr, int* physAddr, int size, bool writing) {
unsigned int vpn = (unsigned) virtAddr / PageSize;
unsigned int offset = (unsigned) virtAddr % PageSize;
TranslationEntry* entry = &pageTable[vpn];
*physAddr = entry->physicalPage * PageSize + offset;
return TRUE;
}
4. 总结
NachOS 的硬件环境是一个模拟的 MIPS R2000/R3000 处理器,选择模拟 MIPS 的原因包括:
- MIPS 的简洁性: 固定指令长度和精简指令集便于教学和模拟。
- 教学目的: MIPS 是计算机体系结构课程中常用的教学架构。
- 历史背景: NachOS 基于已有的 MIPS 模拟器(MIPSSIM)开发。
- 广泛应用: MIPS 在嵌入式系统中有广泛的实际应用。
通过模拟 MIPS,NachOS 为学生提供了一个简化的硬件环境,帮助他们专注于操作系统的设计和实现。
Similar code found with 1 license type
CMoments: NachOS 的硬件环境是一个模拟的 MIPS R2000/R3000 处理器 如何确认这一点?
GitHub Copilot: 可以通过以下几个方面确认 NachOS 的硬件环境是一个模拟的 MIPS R2000/R3000 处理器:
1. NachOS 源代码中的明确说明
在 NachOS 的代码注释中,明确提到 NachOS 模拟的是 MIPS R2000/R3000 处理器。例如,在 mipssim.cc 文件的开头注释中:
1 | |
- 说明: 这里明确指出 NachOS 模拟的是 MIPS R2000/R3000 处理器,并且基于 Ousterhout 的 MIPSSIM 模拟器开发。
2. NachOS 模拟的指令集
NachOS 的 mipssim.cc 文件中实现了 MIPS 指令集的模拟,包括算术指令、逻辑指令、分支指令、加载/存储指令等。这些指令与 MIPS R2000/R3000 的指令集完全一致。
示例代码:
1 | |
- 说明: 这里的
OP_ADD是 MIPS R2000/R3000 的指令,NachOS 模拟了其行为。
3. NachOS 的寄存器模型
NachOS 模拟了 MIPS R2000/R3000 的寄存器模型,包括:
- 通用寄存器(
$0到$31)。 - 特殊寄存器(如
PC、Hi、Lo)。 - 程序计数器(
PC)和异常处理相关寄存器(如BadVAddrReg)。
示例代码:
1 | |
- 说明: NachOS 中的寄存器数量(
NumTotalRegs)与 MIPS R2000/R3000 的寄存器数量一致。
4. NachOS 的内存管理机制
NachOS 模拟了 MIPS 的虚拟内存机制,包括页表和 TLB(Translation Lookaside Buffer)。这些机制是 MIPS R2000/R3000 处理器的重要特性。
示例代码:
1 | |
- 说明: NachOS 模拟了 MIPS 的地址转换机制,包括页表和物理地址计算。
5. NachOS 的异常处理机制
NachOS 模拟了 MIPS 的异常处理机制,包括:
- 系统调用异常(
SyscallException)。 - 算术溢出异常(
OverflowException)。 - 地址错误异常(
AddressErrorException)。
示例代码:
1 | |
- 说明: MIPS R2000/R3000 的
syscall指令会触发系统调用异常,NachOS 模拟了这一行为。
6. NachOS 的指令解码逻辑
NachOS 的 Instruction::Decode 函数解析 MIPS 指令的字段(如操作码、寄存器编号、立即数等),其格式与 MIPS R2000/R3000 的指令格式一致。
示例代码:
1 | |
- 说明: MIPS 指令的固定长度为 32 位,NachOS 的解码逻辑完全符合 MIPS 的指令格式。
7. NachOS 的历史背景
NachOS 的开发者基于 Ousterhout 的 MIPSSIM 模拟器,而 MIPSSIM 是一个专门用于模拟 MIPS R2000/R3000 处理器的软件。这进一步确认了 NachOS 模拟的是 MIPS R2000/R3000。
总结
NachOS 模拟 MIPS R2000/R3000 处理器的证据包括:
- 源代码注释中明确说明。
- 模拟的指令集与 MIPS R2000/R3000 一致。
- 寄存器模型与 MIPS R2000/R3000 相同。
- 内存管理机制(页表和 TLB)符合 MIPS 的特性。
- 异常处理机制与 MIPS 的行为一致。
- 指令解码逻辑完全符合 MIPS 指令格式。
- NachOS 基于 MIPSSIM 开发,而 MIPSSIM 专门模拟 MIPS R2000/R3000。
通过这些特性,可以确认 NachOS 的硬件环境是一个模拟的 MIPS R2000/R3000 处理器。
Similar code found with 1 license type
Q: 可是我的硬件环境明明是Linux Ubuntu,怎么实现MIPS R2000/R3000处理器的?
你的硬件环境确实是 Linux Ubuntu,但 NachOS 并不直接依赖你的物理硬件来运行 MIPS 指令。NachOS 是通过 软件模拟 的方式,在你的 Linux 环境中模拟了一个 MIPS R2000/R3000 处理器。这种模拟是通过 NachOS 的代码实现的,而不是依赖你的实际硬件。
1. NachOS 如何模拟 MIPS 处理器
NachOS 使用软件模拟的方式,在 Linux 环境中实现了 MIPS R2000/R3000 的行为。以下是关键点:
(1) 指令集模拟
NachOS 的
mipssim.cc文件实现了 MIPS 指令集的模拟。每条 MIPS 指令(如
ADD、LW、SW等)都被映射为 C++ 函数中的一个case分支。示例代码:
1
2
3
4
5
6
7
8
9case OP_ADD:
sum = registers[instr->rs] + registers[instr->rt];
if (!((registers[instr->rs] ^ registers[instr->rt]) & SIGN_BIT) &&
((registers[instr->rs] ^ sum) & SIGN_BIT)) {
RaiseException(OverflowException, 0);
return;
}
registers[instr->rd] = sum;
break;- 这里的
OP_ADD是 MIPS 的加法指令,NachOS 使用 C++ 模拟了其行为。
- 这里的
(2) 寄存器模拟
NachOS 使用一个数组
registers来模拟 MIPS 的 32 个通用寄存器和特殊寄存器(如PC、Hi、Lo)。示例代码:
1
2
3
4int Machine::ReadRegister(int num) {
ASSERT((num >= 0) && (num < NumTotalRegs));
return registers[num];
}- 通过
ReadRegister和WriteRegister函数,NachOS 模拟了寄存器的读写操作。
- 通过
(3) 内存管理模拟
NachOS 使用一个数组
mainMemory来模拟物理内存。NachOS 的
Translate函数模拟了 MIPS 的地址转换机制(包括页表和 TLB)。示例代码:
1
2
3
4
5
6
7int Machine::Translate(int virtAddr, int* physAddr, int size, bool writing) {
unsigned int vpn = (unsigned) virtAddr / PageSize;
unsigned int offset = (unsigned) virtAddr % PageSize;
TranslationEntry* entry = &pageTable[vpn];
*physAddr = entry->physicalPage * PageSize + offset;
return TRUE;
}
(4) 异常处理模拟
NachOS 模拟了 MIPS 的异常处理机制(如
SyscallException、OverflowException)。示例代码:
1
2
3
case OP_SYSCALL:
RaiseException(SyscallException, 0);
return;
2. 为什么 NachOS 可以在 Linux 上运行
NachOS 是一个用户态程序,它运行在 Linux 操作系统上,并通过 C++ 代码模拟了 MIPS 的硬件行为。以下是实现的关键点:
(1) NachOS 是一个用户态程序
- NachOS 本身是一个用 C++ 编写的程序,编译后生成一个可执行文件(如
nachos)。 - 这个可执行文件运行在 Linux 用户态,使用 Linux 提供的系统调用(如文件操作、内存分配等)。
(2) MIPS 的行为通过软件模拟
- NachOS 并不依赖你的物理硬件是否支持 MIPS 指令集,而是通过 C++ 代码模拟了 MIPS 的行为。
- 例如,MIPS 的指令解码、执行、寄存器操作等,全部由 NachOS 的代码实现。
(3) 使用交叉编译器生成 MIPS 二进制
- NachOS 的用户程序(如
add.c)需要编译为 MIPS 二进制格式(COFF 文件)。 - 在 Linux 上,使用交叉编译器(如
mipsel-linux-gcc)将用户程序编译为 MIPS 指令集的二进制文件。 - NachOS 加载这些 MIPS 二进制文件,并通过模拟器执行其中的指令。
3. NachOS 的运行流程
编译 NachOS 内核:
- 使用 Linux 上的本地编译器(如
g++)编译 NachOS 的 C++ 源代码,生成nachos可执行文件。
- 使用 Linux 上的本地编译器(如
编译用户程序:
- 使用交叉编译器(如
mipsel-linux-gcc)将用户程序(如add.c)编译为 MIPS 二进制格式(如
- 使用交叉编译器(如
线程同步工具
线程管理,互斥与同步。
课件内容解释了为什么“信号量/互斥锁模拟条件变量”很难可靠
- 条件变量的
wait必须做到“原子释放锁+睡眠”,否则会出现丢信号或永久睡眠等竞态问题。 - 用信号量或互斥锁模拟条件变量时,很难保证“释放锁+等待”是不可分割的原子操作。
- 你的代码其实就是用互斥锁做了“同步屏障”,但如果线程调度发生变化,可能会出现未定义行为或死锁。
mutex解决互斥问题
条件变量实现同步问题
信号量实现共享资源的访问
同步问题的两类错误:
1.order violation:例如:用信号量模拟条件变量的 wait 必须做到“原子释放锁+睡眠”是很难做到的。
2.atomicity violation:例如:使用互斥锁+条件变量模型时,使用锁去做到“原子检查条件+条件改变”。
信号量 v.s. 条件变量
信号量
干净、优雅,完美地解决了生产者-消费者问题
但 “count” 不总是能很好地代表同步条件
条件变量
万能:适用于任何同步条件
丑陋:代码总感觉里有什么脏东西(spin loop)
期末复习
操作系统是这学期投入时间最多的一门课,但这学期还是很忙,没有记些笔记下来,但总的来说还是收获挺多的。
《Operating Systems Three Easy Pieces》,这本书感觉非常好,有点厚但是很可读,它没有罗列知识点而是由简到繁的展现解决问题的过程,
感觉讲的很透彻。
作者的理念是:“Seeing how the sausage was made is nearly as imoprtant as understanding what sausage is good for.”
“To go forth,to study many new and fascinating topics,to learn, to mature, and most importantly, to find something that lights a fire for you.”
王道-2023年计算机考研复习指导
那天青春义卖最后一天晚上去广场薅,1块钱薅到了。做一遍也挺快的三五天就差不多了,感觉道友的复习指导真的很专业。考研直通效果很好。这种先讲知识点之后马上练题的模式很有效。而且感觉作者在写书的过程中是有很多意见收集和思考的,毕竟是来自论坛,应该是经过很多道友打磨过的,内容很有活力。刚出现疑惑就能在章末找到回答。
南京大学-蒋岩炎老师的操作系统2025
历年的课程视频都在B站上有完整录播,这门课也是超级好。关于这门课在网上也是好评无数。今年第一次,课程决定不在课上做操作系统的内核。而是关注利用操作系统提供的接口、工具和方法思路,面向解决实际问题。而且这门课老师也紧跟发展前沿,课程安排也很精巧,课程项目非常实用有趣。获得了不少来自极客的震撼。可以说,这门课给我打开了一个新世界。强烈推荐。还有今年的所有课程实验,强推!
MIT-操作系统S6018
像MIT的校训一样,这门课实践性很强。2020年带来的不只是疫情,还有各大一流院校的线上课。有相当一系列非常好的学习资源被欧美很多前沿计算机院校开源。这门课我还没学完,后边还是想做一些xv6的操作系统内核实验。
其它宝藏:
CS-自学指南
先走出去,路上就会捡到宝藏~~~
PwnCollege
这部分的计算机安全很多还是建立在对操作系统的理解上的。
期末复习(Last-Modified:2025/6/24)
虽然花了不少时间在这个上边,但是也没感觉自己会多少,不过再看教材会感觉清晰很多。期末考前还是得再谨慎过一遍:
进程切换、态的切换、CPU状态的切换,三个之间什么关系?
- 进程切换:进程切换是指操作系统将CPU从一个进程分配给另一个进程的过程。
- 态的切换:态的切换是指进程状态的变换,如从就绪到运行,从运行到阻塞。
- CPU态的切换:CPU状态的切换是指在进程切换时,操作系统需要保存和恢复CPU的寄存器、程序计数器等状态
这三者的关系:进程切换通常伴随态的切换(2次)和CPU态的切换
辉哥给了精准定位-事实证明真是精准。那🆗了。
@全体成员 :各位同学好,今天有几位同学私聊了我一些问题,特来统一回复一下[finally,在凌晨五点左右,我完成了期末试卷的初稿;并且中午左右,其他老师“模块化”检查并修订成了终稿后。]:
1.就期末考试题的分数(百分制)分布,最终如下:
0)往年的4分(个)判断题:今年取消了。
1)选择题:10个*2=20分。大部分是学习通的原题。
2)简答题:7个,分别是{6,6,7,7,7,8,5}分:合计46分。比往年多了2分。
3)计算问答题:3个,分别是9-15分不等。合计34分。比往年多了2分。
2.关于计算问答题,来源和分布是:
1)来源五个:第5章的信号量应用题;第6章的银行家算法;第8章的页调度(也叫页置换/Re-placement)算法;第9章的进程调度;第11章的磁盘调度。
2)信号量必有。
3)银行家算法和进程调度:二选一。
4)页调度算法和磁盘调度:二选一。
请知悉。